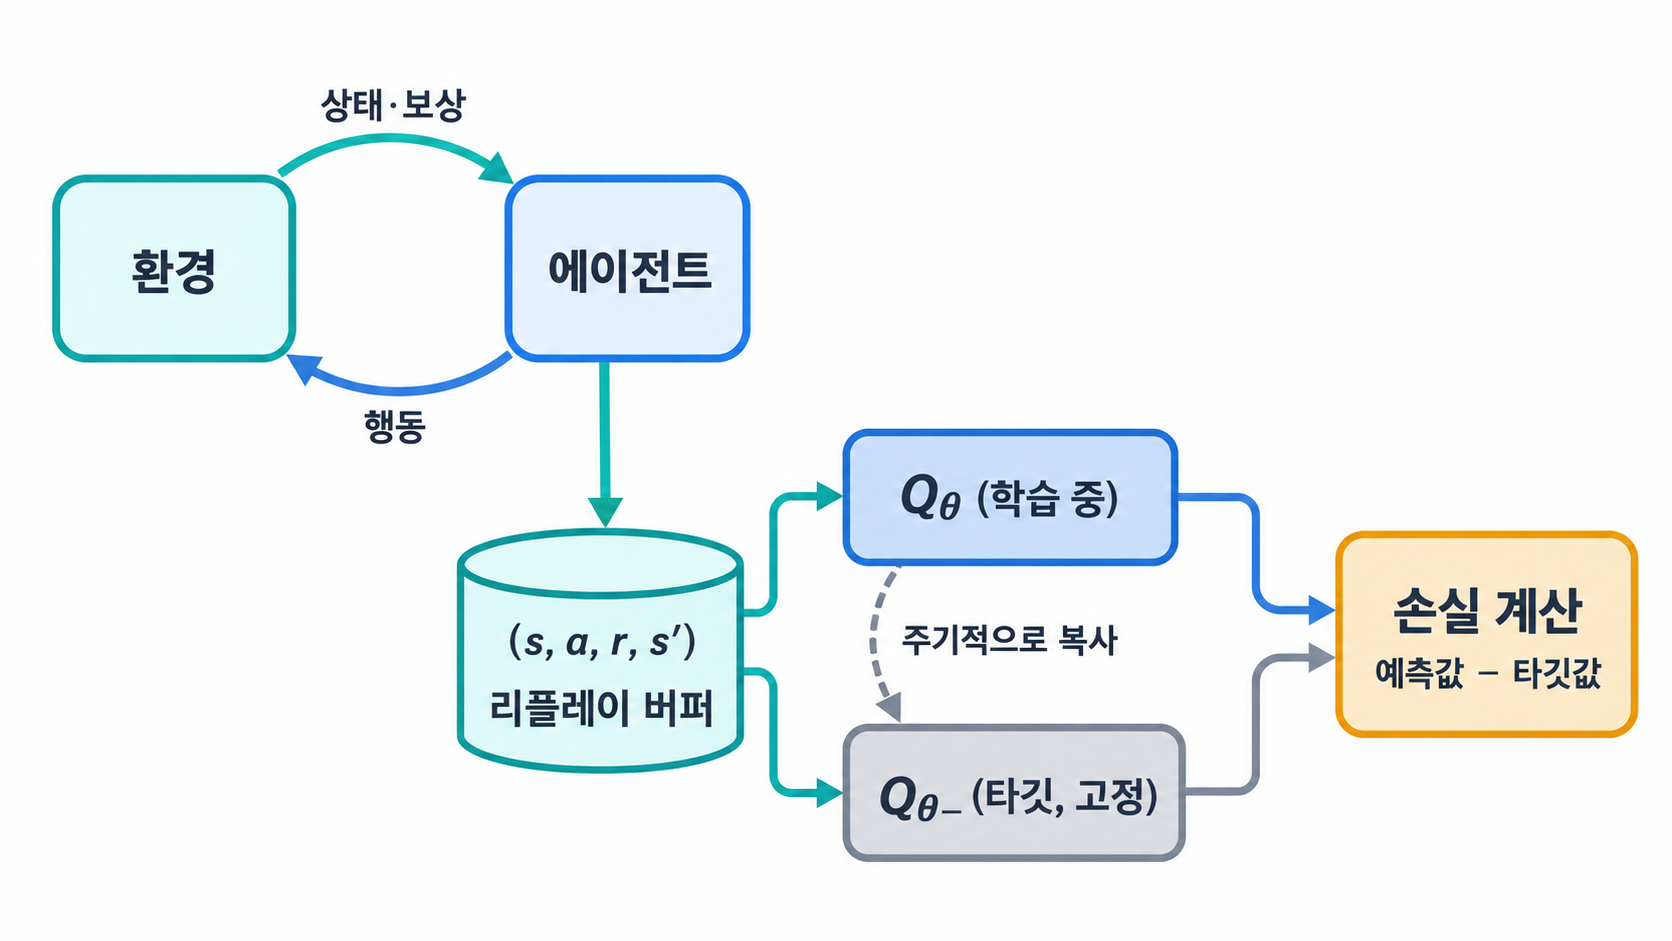
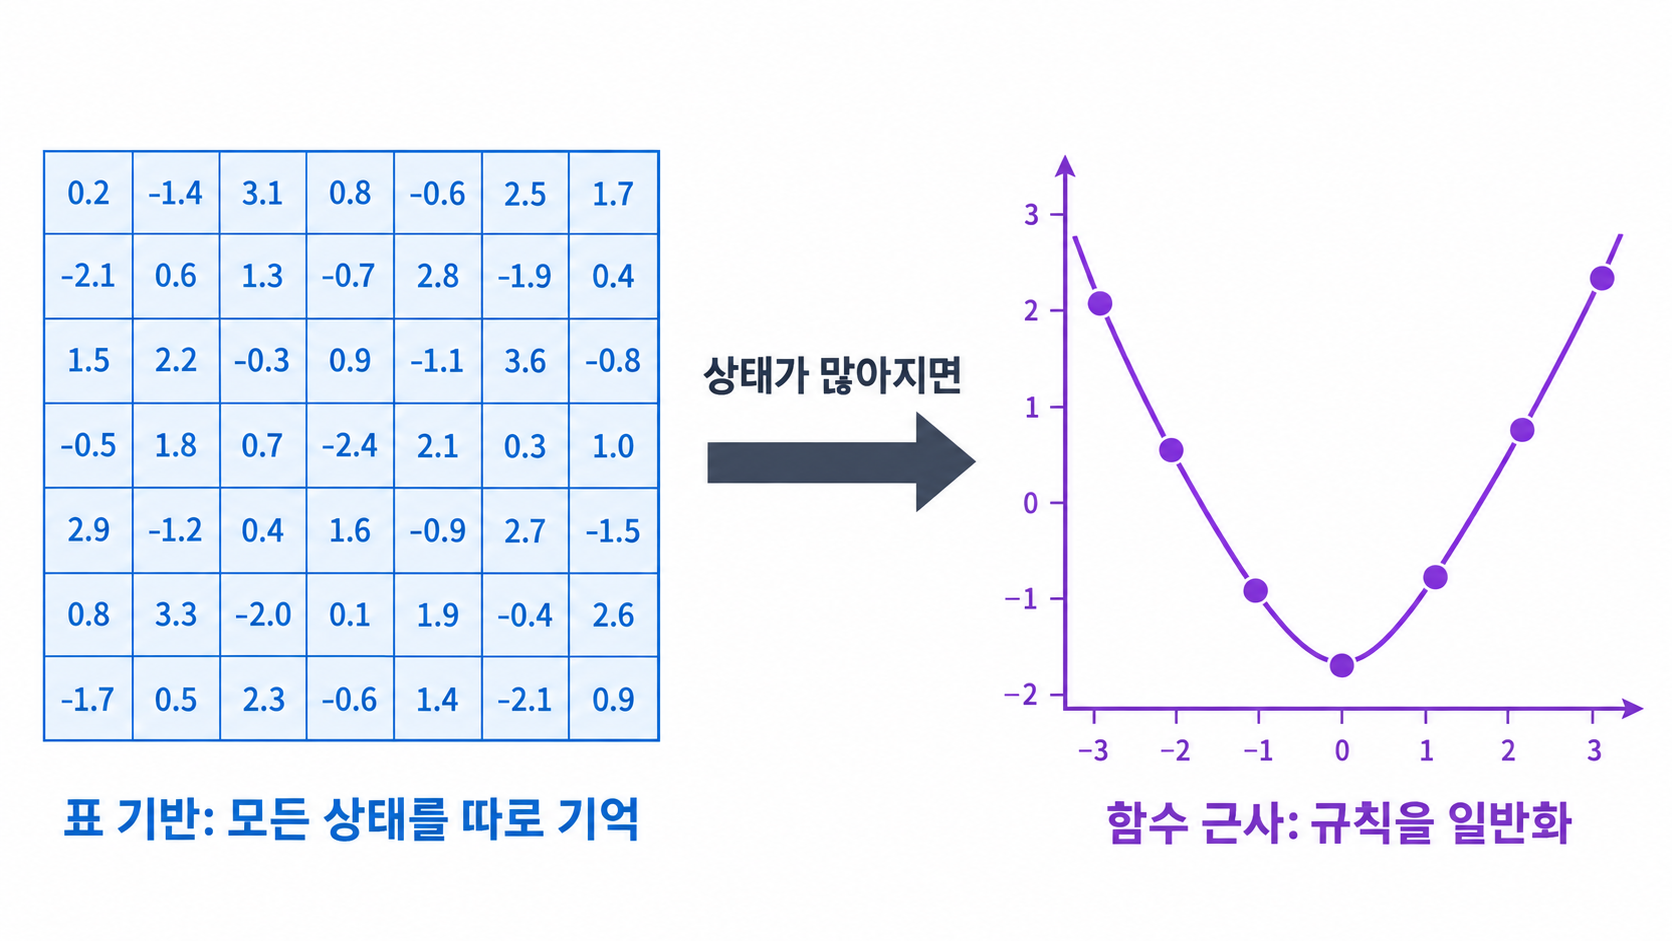
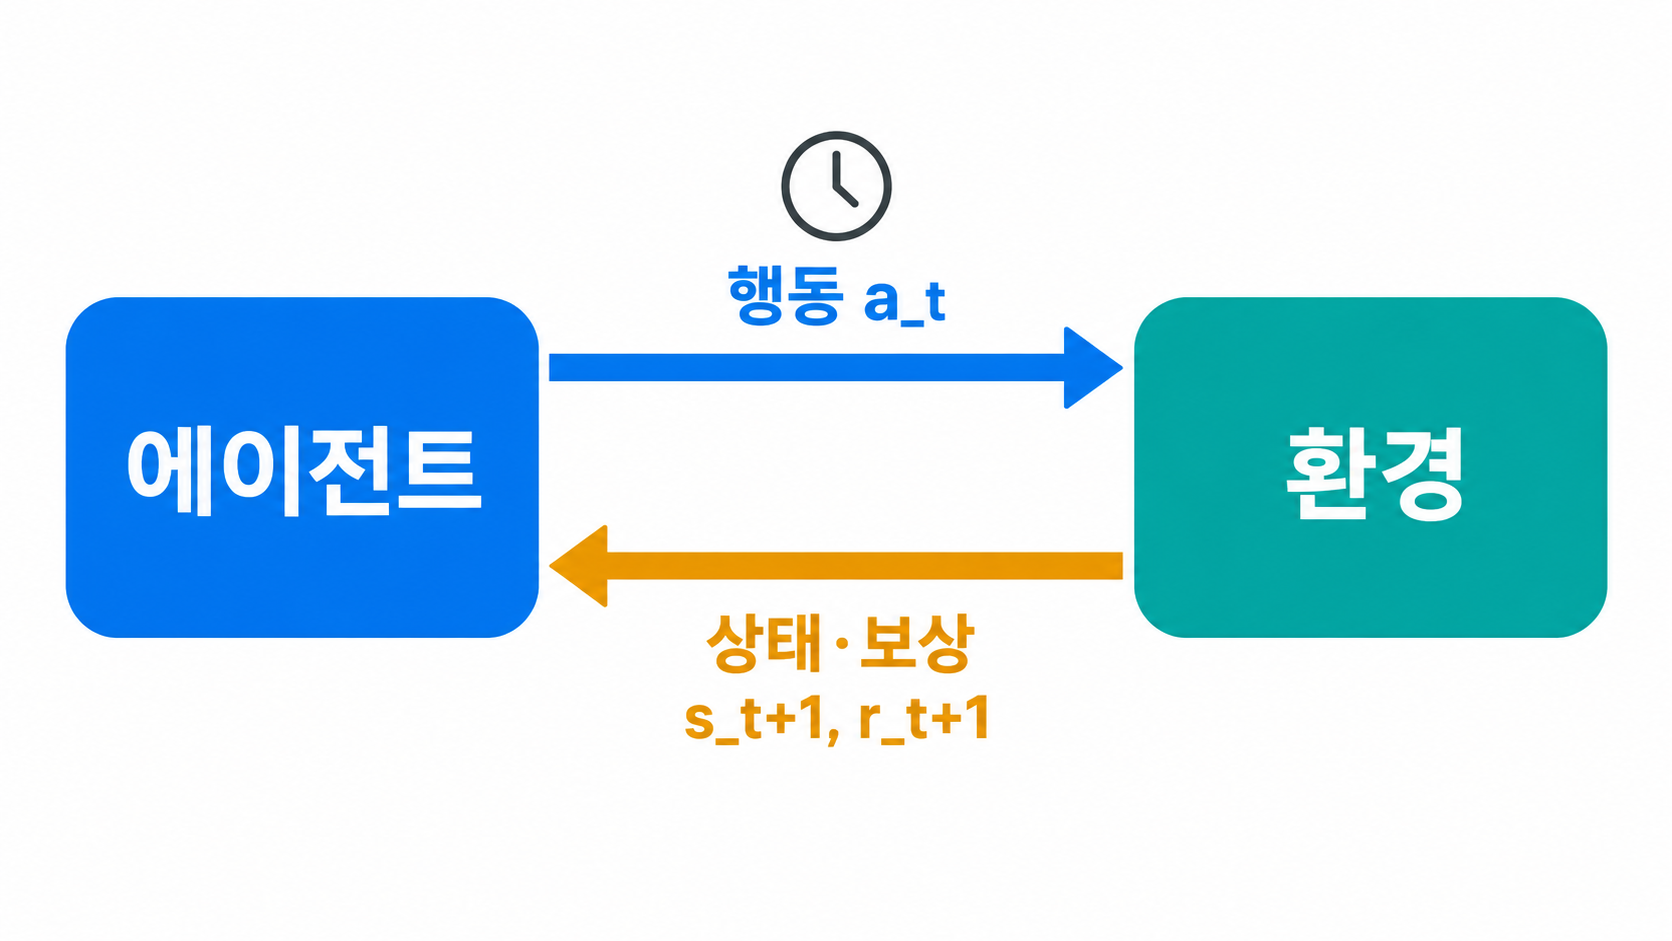
이전에 배운 Q-learning은 $Q(s,a)$ 값을 표에 하나하나 적어가며 학습했습니다. 이제 그 표를 신경망으로 바꿔봅시다. 상태를 입력하면 각 행동의 $Q$ 값을 출력하는 신경망 — 이것이 DQN(Deep Q-Network)의 핵심 아이디어입니다. 말은 간단하지만, "Q-learning의 표를 신경망으로 바꾸기"만 해서는 학습이 제대로 되지 않습니다. 2015년 DeepMind의 연구자들은 이 단순한 아이디어를 실제로 안정적으로 작동하게 만들기 위해 두 가지 핵심 장치를 추가했고, 그 결과가 바로 이번 글에서 배울 DQN 알고리즘입니다.비유의 한계: "표를 신경망으로 바꾼다"는 설명은 직관적이지만, 이 교체가 왜 그렇게 어려운 문제를 일으키는지는 비유만으로는 잘 드러나지 않습니다. 아래 에서 그 ..