내비게이션 앱이 목적지까지의 최단 시간을 계산하는 방식을 떠올려 보세요. 앱은 목적지에서부터 거꾸로 계산합니다. "목적지까지 남은 시간은 0분"이라는 사실에서 출발해, 목적지 바로 앞 교차로들의 "남은 시간"을 계산하고, 그 다음 교차로들의 "남은 시간"을 또 계산하는 식으로 지도 전체에 정보를 퍼뜨립니다. 이렇게 하려면 앱이 도로 지도(어느 교차로가 어디로 연결되고, 각 구간에 얼마나 걸리는지)를 이미 완전히 알고 있어야 합니다. 이번 글에서 배울 동적 계획법(dynamic programming, DP)이 정확히 이런 방식으로 작동합니다. 앞에서 배운 MDP의 전이확률 $P$와 보상함수 $R$을 에이전트가 완전히 알고 있다고 가정하고, 목표(종료 상태)로부터 정보를 거꾸로 전파해 모든 상태의 정확한 가치를 계산합니다.
비유의 한계: 내비게이션은 이미 지도 회사가 만들어 둔 완벽한 지도를 사용하지만, 실제 강화학습 문제 대부분은 이런 완벽한 지도(전이확률과 보상함수)를 갖고 있지 않습니다. 로봇이 처음 보는 방을 탐색하거나, 게임 에이전트가 새로운 스테이지를 만날 때는 환경의 규칙을 미리 알 수 없습니다. 이런 "환경을 모르는" 상황을 다루는 방법은 다음 글(몬테카를로)부터 배웁니다. 동적 계획법은 "환경을 안다면 이론적으로 무엇을 할 수 있는가"에 대한 기준점을 제공하는 역할을 합니다.
벨만 기대방정식
앞 글에서 상태가치 $V^\pi(s)$를 "정책 $\pi$를 따를 때 얻을 리턴의 기댓값"으로 정의했습니다. 이 값은 사실 재귀적인 관계를 만족합니다.
$$
V^\pi(s) = \sum_{a} \pi(a \mid s) \sum_{s'} P(s' \mid s, a) \Big[ R(s, a, s') + \gamma V^\pi(s') \Big]
$$
이 식이 말하는 것은 "지금 상태의 가치"는 "정책에 따라 각 행동을 선택할 확률"과 "그 행동으로 이동할 수 있는 각 다음 상태로 갈 확률"을 모두 고려해, "당장 받는 보상 + 할인된 다음 상태의 가치"를 평균 낸 것과 같습니다. 즉, 가치함수는 자기 자신을 한 단계 미래의 가치함수로 표현할 수 있습니다. 이 재귀 관계를 벨만 기대방정식(Bellman expectation equation)이라고 부릅니다.
벨만 최적방정식
정책을 고정하지 않고 "가장 좋은 정책을 따랐을 때의 가치"를 생각하면, 평균(기댓값) 대신 최댓값을 취하는 식이 됩니다.
$$
V^*(s)
=
\max_{a}
\sum_{s'}
P(s' \mid s,a)
\left[
R(s,a,s')+\gamma V^*(s')
\right]
$$
이 식이 말하는 것은 최적 가치함수 $V^(s)$는 "이 상태에서 할 수 있는 행동 중 가장 좋은 행동 하나를 골랐을 때"의 가치입니다. 정책의 확률을 평균 내는 대신, 가장 좋은 행동 하나만 선택한다는 점이 벨만 기대방정식과의 차이입니다. 이를 벨만 최적방정식(Bellman optimality equation)이라고 부릅니다.
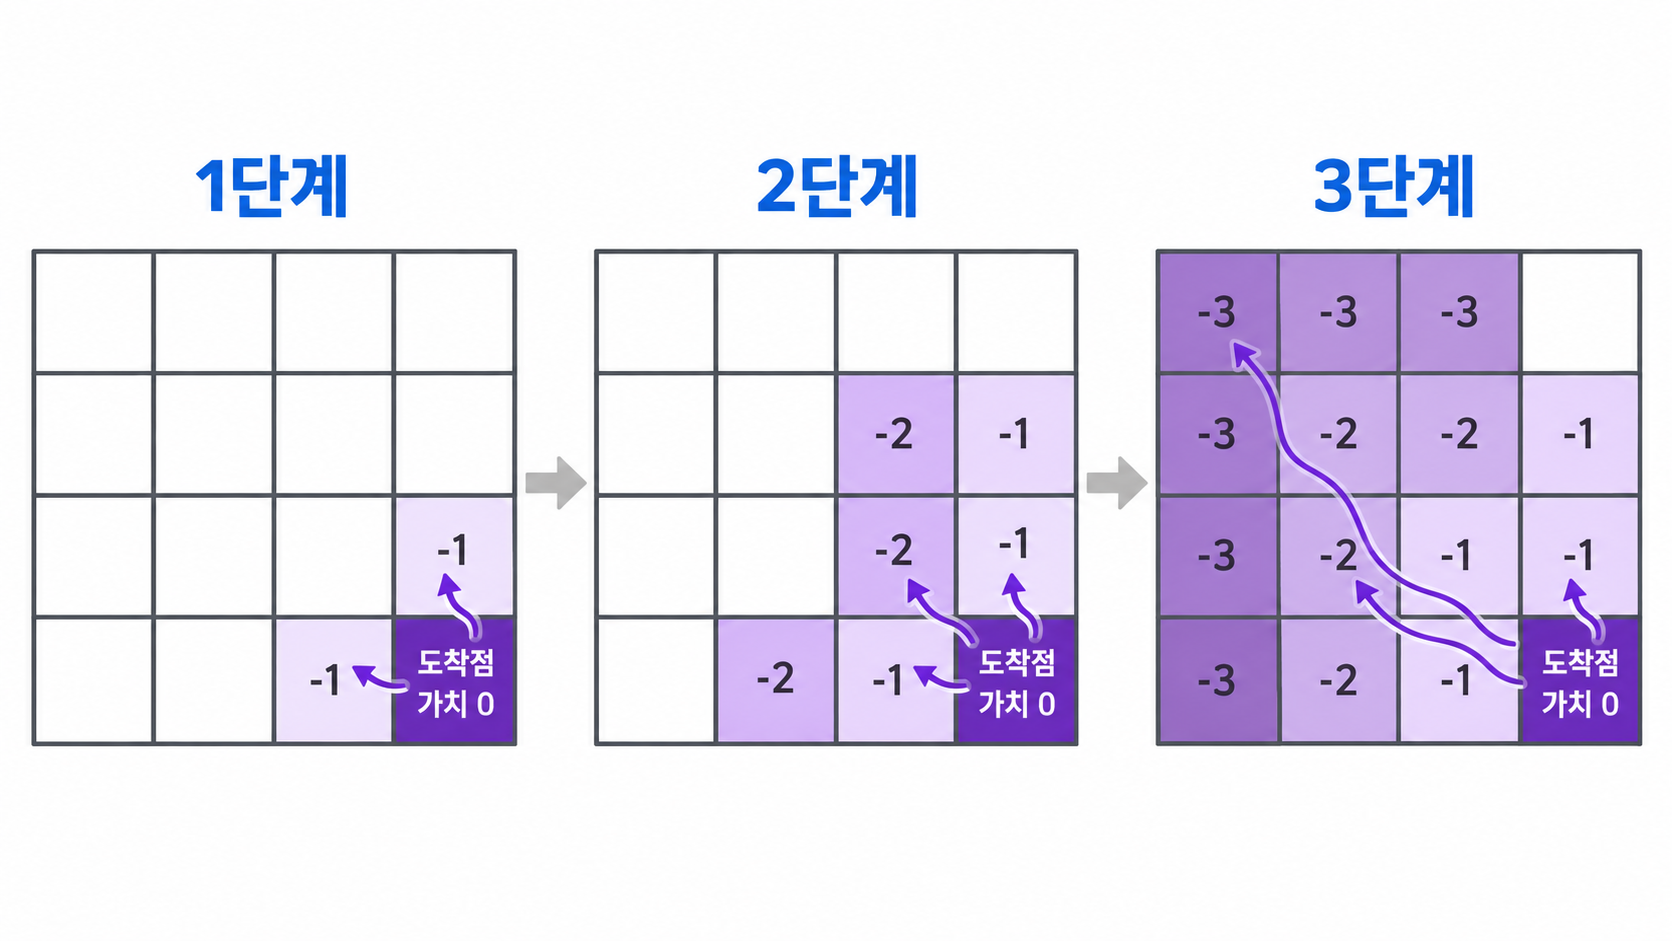
정책 평가, 정책 반복, 가치 반복
반복적 정책 평가(iterative policy evaluation): 정책 $\pi$를 고정해두고, 벨만 기대방정식을 이용해 $V^\pi$를 반복 계산으로 근사합니다. 처음에는 $V(s)=0$으로 시작해서, 모든 상태에 대해 벨만 기대방정식의 우변을 계산해 $V(s)$를 갱신하는 것을 값이 거의 바뀌지 않을 때까지 반복합니다.
정책 반복(policy iteration): 아래 두 단계를 번갈아 반복합니다.
- 정책 평가: 현재 정책 $\pi$에 대한 $V^\pi$를 계산한다.
- 정책 개선: 각 상태에서 $V^\pi$ 기준으로 가장 좋아 보이는 행동을 선택하도록 정책을 업데이트한다. $\pi'(s) = \arg\max_a \sum_{s'} P(s'|s,a)[R(s,a,s') + \gamma V^\pi(s')]$
이 두 단계를 반복하면 정책이 더 이상 바뀌지 않는 지점에서 최적 정책에 도달합니다. 가치 반복(value iteration): 정책 평가를 끝까지 반복하지 않고, 벨만 최적방정식을 한 번씩만 적용하며 가치와 정책 개선을 동시에 진행합니다.
$$
V_{k+1}(s) = \max_a \sum_{s'} P(s' \mid s, a) \Big[ R(s, a, s') + \gamma V_k(s') \Big]
$$
이 식이 말하는 것은 정책 평가가 수렴할 때까지 기다리지 않고, 매번 "지금 알고 있는 가치 추정치를 기준으로 최선의 선택을 했다면"이라는 가정 아래 가치를 한 번에 업데이트합니다. 실무에서는 정책 반복보다 가치 반복이 구현이 더 간단해 자주 사용됩니다.
손으로 계산하기: 미니 정책 평가
3칸짜리 복도 MDP($s_0 \to s_1 \to s_2$, $\gamma=0.9$, 오직 "전진" 행동만 가능)에서 반복적 정책 평가를 손으로 3번 진행해 봅시다. 초기값은 모두 0으로 시작합니다.
| 반복 | $V(s_0)$ | $V(s_1)$ | $V(s_2)$ |
|---|---|---|---|
| 0회 (초기) | 0 | 0 | 0 |
| 1회 | $2 + 0.9 \times 0 = 2.0$ | $4 + 0.9\times 0 = 4.0$ | 0 (종료 상태, 항상 0) |
| 2회 | $2 + 0.9 \times 4.0 = 5.6$ | $4 + 0.9\times 0 = 4.0$ | 0 |
| 3회 | $2 + 0.9 \times 4.0 = 5.6$ | $4 + 0.9\times 0 = 4.0$ | 0 |
2번째 반복에서 이미 앞에서 직접 계산했던 정확한 값($V(s_0)=5.6$, $V(s_1)=4.0$)에 도달했고, 3번째 반복에서는 값이 더 이상 바뀌지 않습니다. 이렇게 "값이 더 이상 바뀌지 않는 지점"을 수렴(convergence)이라고 부릅니다.
코드 예제
"""
gridworld_dp.py — 4장. 환경을 알 때: 동적 계획법
1장의 4x4 GridWorld를 재사용해 정책 반복과 가치 반복으로 최적 정책을 구하고,
화살표로 정책을 출력합니다.

검증 환경: Python 3.11.8, numpy 1.26.4 (외부 RL 라이브러리 불필요)
실행: python gridworld_dp.py
예상 출력: 정책 반복과 가치 반복이 각각 몇 번 만에 수렴했는지, 그리고
           최종 최적 정책이 화살표 격자로 출력됩니다. 이 환경은 결정적이므로
           두 알고리즘 모두 항상 동일한 최적 정책으로 수렴합니다.
"""

import numpy as np

SIZE = 4
GOAL_STATE = SIZE * SIZE - 1
N_STATES = SIZE * SIZE
N_ACTIONS = 4  # 0=위, 1=아래, 2=왼쪽, 3=오른쪽
ACTION_ARROWS = {0: "↑", 1: "↓", 2: "←", 3: "→"}
GAMMA = 0.9


def step_deterministic(state: int, action: int) -> tuple[int, float]:
    """1장 GridWorld와 동일한 규칙의 결정적 전이 함수.
    동적 계획법은 이 전이 규칙(P, R)을 에이전트가 미리 알고 있다고 가정합니다.
    """
    row, col = divmod(state, SIZE)
    if action == 0:
        new_row, new_col = row - 1, col
    elif action == 1:
        new_row, new_col = row + 1, col
    elif action == 2:
        new_row, new_col = row, col - 1
    else:
        new_row, new_col = row, col + 1

    if not (0 <= new_row < SIZE and 0 <= new_col < SIZE):
        return state, -0.1  # 벽에 부딪힘: 제자리, 작은 벌점
    new_state = new_row * SIZE + new_col
    reward = 1.0 if new_state == GOAL_STATE else -0.01
    return new_state, reward


def policy_evaluation(policy: np.ndarray, theta: float = 1e-6, max_iter: int = 10000) -> np.ndarray:
    """주어진 결정적 정책 policy(shape=[N_STATES], 각 원소는 행동 인덱스)에 대해
    벨만 기대방정식을 반복 적용해 V를 계산합니다.
    """
    V = np.zeros(N_STATES)
    for _ in range(max_iter):
        delta = 0.0
        for s in range(N_STATES):
            if s == GOAL_STATE:
                continue  # 종료 상태의 가치는 항상 0으로 고정
            a = policy[s]
            next_state, reward = step_deterministic(s, a)
            new_v = reward + GAMMA * V[next_state]
            delta = max(delta, abs(new_v - V[s]))
            V[s] = new_v
        if delta < theta:
            break
    return V


def policy_improvement(V: np.ndarray) -> np.ndarray:
    """현재 가치함수 V를 기준으로, 각 상태에서 가장 좋은 행동을 선택하는
    새로운 결정적 정책을 만듭니다.
    """
    new_policy = np.zeros(N_STATES, dtype=int)
    for s in range(N_STATES):
        if s == GOAL_STATE:
            continue
        action_values = []
        for a in range(N_ACTIONS):
            next_state, reward = step_deterministic(s, a)
            action_values.append(reward + GAMMA * V[next_state])
        new_policy[s] = int(np.argmax(action_values))
    return new_policy


def policy_iteration() -> tuple[np.ndarray, np.ndarray, int]:
    """정책 평가와 정책 개선을 번갈아 반복해 최적 정책을 찾습니다."""
    policy = np.zeros(N_STATES, dtype=int)  # 초기 정책: 모든 상태에서 "위" 선택
    for iteration in range(1, 1000):
        V = policy_evaluation(policy)
        new_policy = policy_improvement(V)
        if np.array_equal(new_policy, policy):
            return V, policy, iteration
        policy = new_policy
    raise RuntimeError("정책 반복이 수렴하지 않았습니다.")


def value_iteration(theta: float = 1e-6, max_iter: int = 10000) -> tuple[np.ndarray, np.ndarray, int]:
    """벨만 최적방정식을 직접 반복 적용해 최적 가치함수를 계산하고,
    마지막에 한 번만 정책을 추출합니다.
    """
    V = np.zeros(N_STATES)
    for iteration in range(1, max_iter + 1):
        delta = 0.0
        for s in range(N_STATES):
            if s == GOAL_STATE:
                continue
            action_values = []
            for a in range(N_ACTIONS):
                next_state, reward = step_deterministic(s, a)
                action_values.append(reward + GAMMA * V[next_state])
            new_v = max(action_values)
            delta = max(delta, abs(new_v - V[s]))
            V[s] = new_v
        if delta < theta:
            break
    policy = policy_improvement(V)
    return V, policy, iteration


def print_policy_grid(policy: np.ndarray, title: str) -> None:
    print(f"\n{title}")
    for row in range(SIZE):
        line = []
        for col in range(SIZE):
            s = row * SIZE + col
            if s == GOAL_STATE:
                line.append(" G ")
            else:
                line.append(f" {ACTION_ARROWS[policy[s]]} ")
        print("".join(line))


def main() -> None:
    print("=== 정책 반복 (Policy Iteration) ===")
    V_pi, policy_pi, n_iter_pi = policy_iteration()
    print(f"수렴까지 반복 횟수: {n_iter_pi}")
    print_policy_grid(policy_pi, "정책 반복으로 찾은 최적 정책:")
    print(f"\nV(시작 칸, state=0) = {V_pi[0]:.4f}")

    print("\n=== 가치 반복 (Value Iteration) ===")
    V_vi, policy_vi, n_iter_vi = value_iteration()
    print(f"수렴까지 반복 횟수: {n_iter_vi}")
    print_policy_grid(policy_vi, "가치 반복으로 찾은 최적 정책:")
    print(f"\nV(시작 칸, state=0) = {V_vi[0]:.4f}")

    same_policy = np.array_equal(policy_pi, policy_vi)
    print(f"\n두 알고리즘이 같은 정책에 도달했는가? {same_policy}")
    print(f"두 알고리즘의 V(0) 차이: {abs(V_pi[0] - V_vi[0]):.6f}")


if __name__ == "__main__":
    main()
예상 출력:
=== 정책 반복 (Policy Iteration) ===
수렴까지 반복 횟수: 5
정책 반복으로 찾은 최적 정책:
 ↓  ↓  ↓  ↓
 ↓  ↓  ↓  ↓
 ↓  ↓  ↓  ↓
 →  →  →  G

V(시작 칸, state=0) = 0.5495

=== 가치 반복 (Value Iteration) ===
수렴까지 반복 횟수: 7
가치 반복으로 찾은 최적 정책:
 ↓  ↓  ↓  ↓
 ↓  ↓  ↓  ↓
 ↓  ↓  ↓  ↓
 →  →  →  G

V(시작 칸, state=0) = 0.5495

두 알고리즘이 같은 정책에 도달했는가? True
두 알고리즘의 V(0) 차이: 0.000000
최적 경로는 출발점(0번 칸)에서 도착점(15번 칸)까지 최소 6걸음(아래로 3번, 오른쪽으로 3번)이 필요합니다. 어떤 순서로 아래·오른쪽을 섞어도 걸음 수와 리턴은 같으므로, 초기 정책이나 동점 처리 방식에 따라 "먼저 오른쪽으로 가는 경로"나 "먼저 아래로 가는 경로" 등 다른 모양의 화살표가 나올 수 있습니다 — 이 역시 정답입니다. V(0)=0.5495는 손으로도 검산할 수 있습니다:
처음 5걸음은 각각 -0.01의 보상을 받고, 마지막 6번째 걸음에서 도착점에 도달해 +1.0을 받습니다. 이를 할인율 0.9로 할인해 더하면 $\sum_{i=0}^{4} 0.9^i \times(-0.01) + 0.9^5 \times 1.0 \approx 0.5495$로 정확히 일치합니다.
코드를 한 줄씩 이해하기
step_deterministic: 앞에서 다룬GridWorld.step과 똑같은 전이 규칙이지만, 객체 상태(self.state)를 바꾸지 않고 순수 함수로 만들었습니다. 동적 계획법은 "실제로 행동해보지 않고도" 모든 $(s,a,s')$ 조합에 대한 전이와 보상을 계산할 수 있어야 하므로, 이런 순수 함수 형태가 자연스럽습니다.policy_evaluation의delta: 한 번의 전체 상태 순회(sweep) 동안 가치가 얼마나 바뀌었는지의 최댓값입니다.delta < theta가 되면 "거의 다 바뀌었다"고 보고 반복을 멈춥니다.theta가 작을수록 더 정확하지만 더 오래 걸립니다.policy_improvement: 모든 행동에 대해 "당장 보상 + 할인된 다음 상태 가치"를 계산한 뒤argmax로 가장 좋은 행동을 고릅니다. 이는 벨만 최적방정식의 우변을 그대로 코드로 옮긴 것입니다.policy_iteration의 종료 조건:new_policy가policy와 완전히 같아지면(더 이상 개선할 행동이 없으면) 최적 정책에 도달했다고 보고 멈춥니다. 이는 정책 반복이 유한한 상태 공간에서 반드시 종료됨을 보장하는 핵심 아이디어입니다.value_iteration:policy_evaluation처럼 정책을 끝까지 평가하지 않고, 매 반복마다 바로max를 취해 가치를 갱신합니다. 마지막에 딱 한 번policy_improvement를 호출해 정책을 뽑아냅니다.
직접 바꾸어 보는 실험
GAMMA를 0.9에서 0.5로 낮추면 최적 정책의 경로가 달라질까요? (힌트: 이 GridWorld는 보상 구조가 단순해 경로 자체는 잘 바뀌지 않을 수 있지만,V(0)의 절대값은 달라집니다. 직접 확인해보세요.)- 벽에 부딪혔을 때의 벌점을 -0.1에서 -5.0으로 크게 늘리면, 최적 정책이 격자 가장자리를 피해 가는 모습이 나타나는지 관찰해보세요.
theta를 1e-6에서 1e-2로 크게 늘리면 가치 반복의 반복 횟수와 최종V(0)값이 어떻게 달라지는지 비교해보세요. 정확도와 속도의 trade-off를 체감할 수 있습니다.
자주 하는 실수
- 종료 상태의 가치를 갱신 대상에 포함시키는 경우: 종료 상태는 더 이상 전이가 없으므로 그 가치는 항상 0(또는 문제 정의에 따른 고정값)이어야 합니다. 코드에서
if s == GOAL_STATE: continue로 명시적으로 건너뛰는 이유입니다. - 정책 반복에서 "정책 평가"를 완전히 수렴시키지 않고 정책 개선으로 넘어가는 경우: 이렇게 하면 사실상 가치 반복과 비슷해집니다(실제로 이런 절충안을 "수정된 정책 반복"이라 부르기도 합니다). 이 글에서는 두 알고리즘의 차이를 명확히 보여주기 위해 정책 평가를 완전히 수렴시켰습니다.
- 행동가치 $Q$ 대신 상태가치 $V$만으로 정책을 개선하려다 전이확률을 빠뜨리는 경우: $V$만으로 다음 행동을 고르려면 반드시 "그 행동을 했을 때 어떤 상태로 가는지"를 알아야 합니다(즉 $P$가 필요합니다). 환경을 모르면 $V$만으로는 행동을 고를 수 없다는 점이, 다음 글부터 $Q$를 직접 학습하는 방법들이 중요해지는 이유이기도 합니다.
동적 계획법은 강력하지만 "환경을 완전히 안다"는 현실적이지 않은 가정에 기대고 있습니다. 다음 글에서는 이 가정을 완전히 내려놓고, 에이전트가 환경과 직접 상호작용하며 얻은 경험(에피소드)만으로 가치를 추정하는 첫 번째 방법인 몬테카를로(Monte Carlo, MC) 방법을 배웁니다.
'머신러닝' 카테고리의 다른 글
| 강화학습 6 - 시간차 학습 (기다리지 않고 배우기) (0) | 2026.09.30 |
|---|---|
| 강화학습 5 - 몬테카를로 (끝까지 경험하고 배우기) (0) | 2026.09.30 |
| 강화학습 3 - 가장 단순한 강화학습: 멀티암드 밴딧 (1) | 2026.09.21 |
| 강화학습 2 - MDP라는 강화학습의 지도 (0) | 2026.09.18 |
| 강화학습 1 - 강화학습은 무엇을 배우는가? (0) | 2026.09.17 |