내비게이션 앱을 켜고 목적지를 입력하면, 앱은 지금 여러분이 있는 위치(상태)와 가능한 경로들(행동)을 보고, 각 경로의 예상 소요 시간(비용, 즉 음의 보상)을 계산해 최선의 경로(정책)를 추천합니다. 이때 중요한 사실이 하나 있습니다. 내비게이션은 "여러분이 어떻게 지금 위치까지 왔는지"는 신경 쓰지 않습니다. 고속도로로 왔든, 국도로 왔든, 지금 이 교차로에 서 있다는 사실만 알면 다음 경로를 똑같이 추천합니다. 이 성질 — "미래를 결정하는 데 과거 전체가 아니라 현재 상태만 있으면 충분하다" — 이 바로 이번 글의 핵심인 마르코프 성질(Markov property)입니다. 이 성질을 만족하는 문제를 수학적으로 정리한 틀이 마르코프 결정과정(Markov Decision Process, MDP)입니다.
마르코프 성질
마르코프 성질은 다음과 같이 표현됩니다.
$$
P(s_{t+1} \mid s_t, a_t, s_{t-1}, a_{t-1}, \dots, s_0, a_0) = P(s_{t+1} \mid s_t, a_t)
$$
다음 상태 $s_{t+1}$이 나올 확률은, 과거의 모든 상태와 행동을 다 알고 있을 때나 그냥 "현재 상태 $s_t$와 방금 한 행동 $a_t$"만 알고 있을 때나 똑같다는 뜻입니다. 즉, 현재 상태에 미래를 예측하는 데 필요한 모든 정보가 이미 압축되어 있다는 뜻입니다.
비유의 한계: 내비게이션 비유는 마르코프 성질을 직관적으로 보여주지만, 실제 문제에서 "현재 상태"를 무엇으로 정의하느냐에 따라 마르코프 성질이 성립하기도, 하지 않기도 합니다. 예를 들어 자동차의 "현재 위치"만 상태로 쓰면 마르코프 성질이 깨질 수 있습니다(같은 위치라도 속도가 다르면 다음 위치가 다르므로). 이때는 위치와 속도를 함께 상태에 포함시켜야 마르코프 성질이 (근사적으로나마) 성립합니다. 이처럼 "상태를 잘 설계하는 것" 자체가 강화학습에서 중요한 작업입니다.
MDP의 다섯 요소
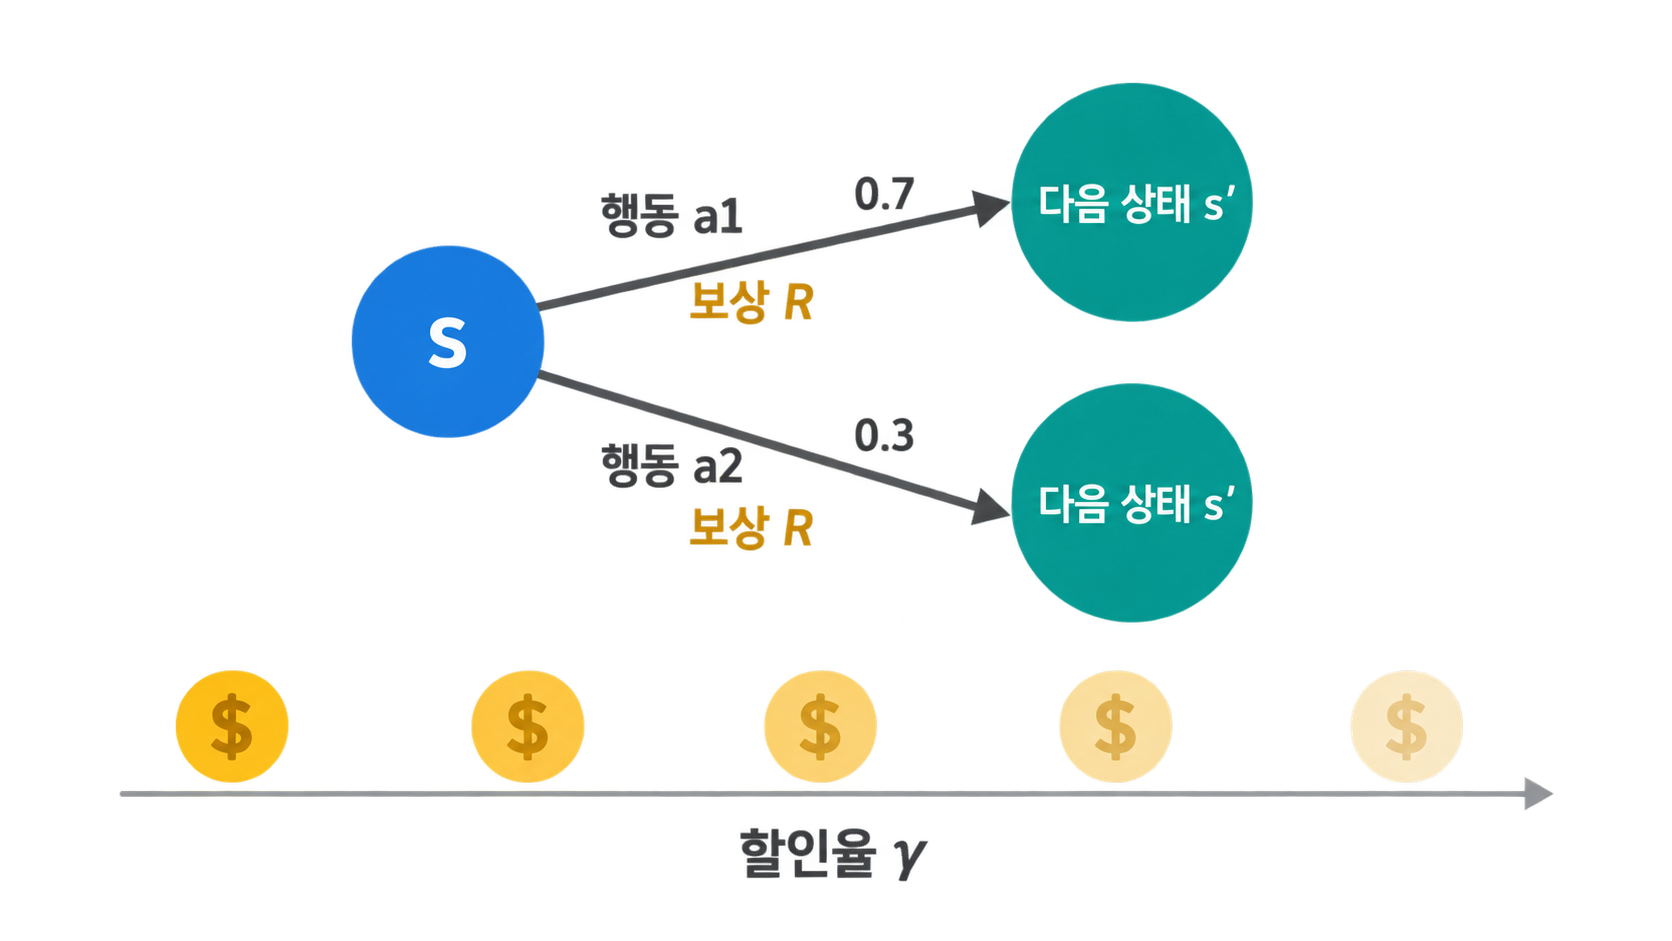
MDP는 다음 다섯 가지 요소의 튜플 $(S, A, P, R, \gamma)$로 정의됩니다.
- $S$ (상태 집합, state space): 가능한 모든 상태의 모음
- $A$ (행동 집합, action space): 가능한 모든 행동의 모음
- $P(s' \mid s, a)$ (상태전이확률, transition probability): 상태 $s$에서 행동 $a$를 했을 때 다음 상태가 $s'$이 될 확률
- $R(s, a, s')$ (보상함수, reward function): 상태 $s$에서 행동 $a$를 해서 $s'$으로 이동했을 때 받는 보상
- $\gamma$ (할인율, discount factor): 0과 1 사이의 값으로, 미래 보상을 현재 가치로 얼마나 깎아서 볼지 정하는 숫자
내비게이션 비유로 다시 보면:
| 상태 $S$ | 지도 위의 모든 교차로 |
| 행동 $A$ | 각 교차로에서 선택 가능한 방향 |
| 전이확률 $P$ | 그 방향으로 갔을 때 실제로 어느 도로로 이어지는지(신호 대기, 사고 등으로 불확실할 수 있음) |
| 보상 $R$ | 그 구간을 이동하는 데 걸리는 시간(음수로 표현: 시간이 길수록 더 나쁨) |
| 할인율 $\gamma$ | "당장의 1분"과 "10분 뒤의 1분"을 같은 무게로 볼지, 아니면 당장의 시간을 더 중요하게 볼지 |
정책, 리턴, 가치함수
정책(policy) $\pi$는 상태를 보고 행동을 고르는 규칙입니다. 두 가지 형태가 있습니다.
- 결정적 정책(deterministic policy): $\pi(s) = a$ — 상태 $s$에서 항상 행동 $a$를 선택
- 확률적 정책(stochastic policy): $\pi(a \mid s)$ — 상태 $s$에서 행동 $a$를 선택할 확률
할인된 리턴(discounted return) $G_t$는 시각 $t$ 이후 받을 보상들을 할인율로 깎아 더한 값입니다.
$$
G_t = r_{t+1} + \gamma r_{t+2} + \gamma^2 r_{t+3} + \dots = \sum_{k=0}^{\infty} \gamma^k r_{t+k+1}
$$
이 식이 의미하는 것은 지금부터 미래에 받을 보상들을 모두 더하되, 먼 미래의 보상일수록 $\gamma$를 여러 번 곱해서 조금씩 깎아서 계산한다는 뜻입니다. $\gamma$가 0에 가까우면 "당장 눈앞의 보상"만 중요하게 여기는 근시안적 에이전트가 되고, $\gamma$가 1에 가까우면 "먼 미래의 보상"까지 거의 같은 무게로 고려하는 장기적인 에이전트가 됩니다.
상태가치 함수(state-value function) $V^\pi(s)$는 정책 $\pi$를 따를 때, 상태 $s$에서 시작해서 앞으로 받을 리턴의 기댓값입니다.
$$
V^\pi(s) = \mathbb{E}_\pi[G_t \mid s_t = s]
$$
이 식이 말하는 것은 "이 상태에 있으면, 이 정책을 계속 따랐을 때 평균적으로 얼마나 좋은 결과를 얻는가"를 하나의 숫자로 나타낸 것입니다. 행동가치 함수(action-value function, Q-function) $Q^\pi(s, a)$는 상태 $s$에서 행동 $a$를 하고, 그 이후로는 정책 $\pi$를 따를 때 얻을 리턴의 기댓값입니다.
$$
Q^\pi(s, a) = \mathbb{E}_\pi[G_t \mid s_t = s, a_t = a]
$$
이 식이 말하는 것은 "이 상태에서 이 행동을 선택하면, 그 이후로는 정책을 따랐을 때 평균적으로 얼마나 좋은가"를 나타냅니다. $V^\pi$가 "상태 자체의 좋음"을 평가한다면, $Q^\pi$는 "그 상태에서 특정 행동을 골랐을 때의 좋음"을 평가한다는 차이가 있습니다.
손으로 계산하기: 3개 상태 MDP
아래처럼 아주 단순한 3개 상태 MDP를 생각해 봅시다.
- 상태: $S = {s_0, s_1, s_2}$ ($s_2$는 종료 상태)
- 행동: 오직 하나뿐인 행동 "전진"만 가능 (선택의 여지가 없으므로 정책은 자동으로 결정됨)
- 전이: $s_0 \to s_1 \to s_2$ (확률 1로 결정적 전이)
- 보상: $s_0 \to s_1$ 전이 시 보상 2, $s_1 \to s_2$ 전이 시 보상 4
- 할인율: $\gamma = 0.9$
$s_0$의 상태가치를 계산해 봅시다.
$$
V(s_0) = r_1 + \gamma r_2 = 2 + 0.9 \times 4 = 2 + 3.6 = 5.6
$$
$s_1$의 상태가치는:
$$
V(s_1) = r_2 = 4
$$
$s_2$는 종료 상태이므로 $V(s_2) = 0$입니다(더 이상 받을 보상이 없기 때문).
이제 할인율을 $\gamma = 0.5$로 바꾸면 어떻게 될까요?
$$
V(s_0) = 2 + 0.5 \times 4 = 4.0
$$
할인율이 작아지자 $s_0$의 가치가 5.6에서 4.0으로 줄었습니다. 이는 먼 미래의 보상(여기서는 두 번째 보상 4)의 영향력이 줄어들었기 때문입니다. 아래 코드에서 이 관계를 다양한 $\gamma$ 값에 대해 그래프로 직접 확인해 봅니다.
100% 실행되는 코드
"""
small_mdp_simulator.py — 2장. MDP라는 강화학습의 지도
3개 상태로 이루어진 아주 작은 결정적 MDP를 시뮬레이션하고,
할인율(gamma)이 상태가치에 미치는 영향을 그래프로 저장합니다.

검증 환경: Python 3.11.8, matplotlib 3.8.4 (외부 RL 라이브러리 불필요)
실행: python small_mdp_simulator.py
예상 출력: gamma=0.9, gamma=0.5일 때 V(s0), V(s1)이 콘솔에 출력되고,
           artifacts/ch02/discount_effect.png에 gamma-V(s0) 관계 그래프가 저장됩니다.
"""

import os
import sys

import numpy as np

sys.path.append(os.path.join(os.path.dirname(__file__), "..", "common"))
from rl_utils import setup_korean_font  # noqa: E402


class SimpleMDP:
    """s0 -> s1 -> s2(종료) 로 이어지는 결정적 3상태 MDP.

    행동은 "전진" 하나뿐이므로 정책을 고민할 필요가 없고, 오직 할인율만
    바꿔가며 상태가치가 어떻게 변하는지에 집중할 수 있습니다.
    """

    def __init__(self, gamma: float):
        self.gamma = gamma
        # 전이: 상태 i에서 전진하면 상태 i+1로 이동, 보상은 rewards[i]
        self.rewards = {0: 2.0, 1: 4.0}  # s0->s1 보상, s1->s2 보상
        self.terminal_state = 2

    def compute_state_values(self) -> dict:
        """이 MDP는 상태가 3개뿐이고 전이가 결정적이므로, 뒤에서부터
        (종료 상태부터) 거슬러 올라가며 상태가치를 정확히 계산할 수 있습니다.
        이는 4장에서 배울 동적 계획법의 가장 단순한 형태이기도 합니다.
        """
        V = {self.terminal_state: 0.0}  # 종료 상태의 가치는 항상 0
        # s1의 가치: 이후 받을 보상은 rewards[1] 하나뿐
        V[1] = self.rewards[1] + self.gamma * V[self.terminal_state]
        # s0의 가치: rewards[0] + gamma * V(s1)
        V[0] = self.rewards[0] + self.gamma * V[1]
        return V


def main() -> None:
    print("=== 할인율에 따른 상태가치 변화 ===\n")

    for gamma in [0.9, 0.5]:
        mdp = SimpleMDP(gamma=gamma)
        V = mdp.compute_state_values()
        print(f"gamma={gamma}: V(s0)={V[0]:.3f}, V(s1)={V[1]:.3f}, V(s2)={V[2]:.3f}")

    print("\n=== gamma를 0부터 1까지 촘촘히 바꿔가며 V(s0) 계산 ===")
    gammas = np.linspace(0.0, 1.0, 101)
    v0_values = []
    for g in gammas:
        mdp = SimpleMDP(gamma=g)
        V = mdp.compute_state_values()
        v0_values.append(V[0])

    os.makedirs("artifacts/ch02", exist_ok=True)
    setup_korean_font()

    import matplotlib

    matplotlib.use("Agg")
    import matplotlib.pyplot as plt

    fig, ax = plt.subplots(figsize=(7, 4.5))
    ax.plot(gammas, v0_values, color="tab:purple", linewidth=2)
    ax.axhline(y=mdp.rewards[0] + mdp.rewards[1], color="gray", linestyle="--", alpha=0.5,
               label="gamma=1일 때 극한값 (2+4=6)")
    ax.set_title("할인율(gamma)에 따른 V(s0)의 변화")
    ax.set_xlabel("할인율 gamma")
    ax.set_ylabel("V(s0)")
    ax.legend()
    ax.grid(alpha=0.3)
    fig.tight_layout()
    fig.savefig("artifacts/ch02/discount_effect.png", dpi=150)
    plt.close(fig)

    print("그래프 저장 완료: artifacts/ch02/discount_effect.png")
    print(f"gamma=0.0일 때 V(s0)={v0_values[0]:.3f} (당장의 보상 2만 반영)")
    print(f"gamma=1.0일 때 V(s0)={v0_values[-1]:.3f} (미래 보상까지 전부 반영: 2+4=6)")


if __name__ == "__main__":
    main()
예상 출력:
=== 할인율에 따른 상태가치 변화 ===

gamma=0.9: V(s0)=5.600, V(s1)=4.000, V(s2)=0.000
gamma=0.5: V(s0)=4.000, V(s1)=4.000, V(s2)=0.000

=== gamma를 0부터 1까지 촘촘히 바꿔가며 V(s0) 계산 ===
그래프 저장 완료: artifacts/ch02/discount_effect.png
gamma=0.0일 때 V(s0)=2.000 (당장의 보상 2만 반영)
gamma=1.0일 때 V(s0)=6.000 (미래 보상까지 전부 반영: 2+4=6)
이 코드는 결정적 전이이므로 무작위성이 전혀 없어, 매번 실행해도 완전히 동일한 숫자가 나옵니다(별도의 seed 고정이 필요 없는 특수한 경우입니다).
코드를 한 줄씩 이해하기
SimpleMDP.compute_state_values: 종료 상태의 가치를 0으로 놓고 "뒤에서부터" 거슬러 올라가며 계산합니다. 이는 미래의 가치를 먼저 알아야 현재의 가치를 계산할 수 있다는 벨만 방정식의 재귀적 구조를 그대로 보여주는 예고편입니다(벨만 방정식은 추후에 본격적으로 다룹니다).gammas = np.linspace(0.0, 1.0, 101): 0부터 1까지를 101개의 점으로 촘촘히 나눕니다.shape은(101,)인 1차원 NumPy 배열입니다.ax.axhline(...): $\gamma=1$일 때의 극한값(모든 미래 보상을 깎지 않고 그대로 더한 값, $2+4=6$)을 점선으로 표시해, 곡선이 이 값에 점근하는 모습을 시각적으로 확인할 수 있게 합니다.
직접 바꾸어 보는 실험
self.rewards를{0: 2.0, 1: -10.0}처럼 두 번째 보상을 음수로 바꾸면, 할인율이 커질수록 $V(s_0)$이 어떻게 변할지 예측해보고 실행해 확인해보세요.- 상태를 하나 더 추가해 4개 상태 MDP($s_0 \to s_1 \to s_2 \to s_3$)로 확장하고,
compute_state_values를 일반화된 반복문으로 다시 작성해보세요. - $\gamma$가 정확히 1일 때 무한히 긴 에피소드(종료 상태가 없는 MDP)라면 리턴 $G_t$의 합이 어떻게 될지 생각해보세요. (힌트: 왜 많은 강화학습 알고리즘이 $\gamma < 1$을 기본값으로 쓰는지와 관련이 있습니다.)
자주 하는 실수
- 할인율을 1로 놓고 종료되지 않는(끝없이 이어지는) 문제를 다루는 경우: 보상이 계속 양수라면 리턴이 무한대로 발산할 수 있습니다. 종료 상태가 없는 문제에서는 반드시 $\gamma < 1$을 사용하거나, 문제를 유한한 에피소드로 설계해야 합니다.
- $V^\pi(s)$와 $Q^\pi(s,a)$를 혼동하는 경우: $V$는 상태만의 함수이고, $Q$는 상태와 행동의 쌍에 대한 함수입니다. "이 상태가 좋다"와 "이 상태에서 이 행동을 하는 것이 좋다"는 다른 질문입니다.
- 리턴 $G_t$를 그냥 "총 보상의 합"이라고만 기억하고 할인율을 빠뜨리는 경우: 할인율이 없는 리턴은 $\gamma=1$인 특수한 경우일 뿐입니다.
MDP는 상태와 행동이 여러 개이고 전이가 확률적일 때 진가를 발휘합니다. 하지만 그 전에, "상태가 하나뿐이고 행동만 여러 개인" 가장 단순한 특수 사례를 통해 탐색과 활용의 딜레마를 깊이 파고드는 것이 좋은 다음 걸음입니다. 다음 글에서는 멀티암드 밴딧(multi-armed bandit) 문제를 통해 이 딜레마를 정면으로 다루고, ε-greedy, UCB, Thompson sampling 같은 실전 전략들을 비교합니다.
'머신러닝' 카테고리의 다른 글
| 강화학습 4 - 동적 계획법 (환경을 알 때) (0) | 2026.09.27 |
|---|---|
| 강화학습 3 - 가장 단순한 강화학습: 멀티암드 밴딧 (1) | 2026.09.21 |
| 강화학습 1 - 강화학습은 무엇을 배우는가? (0) | 2026.09.17 |
| 강화학습 0 - 보상을 따라 스스로 배우는 기계 (0) | 2026.09.17 |
| 차원의 저주 11 - 차원 수보다 구조를 보라! (0) | 2026.09.15 |