먼저 만나는 이야기
시험을 앞둔 두 학생이 있습니다. 학생 A는 지난 10년간 나온 기출문제 1,000개를 통째로 외웠습니다. 시험에 정확히 그 문제가 나오면 완벽하게 풀지만, 숫자만 살짝 바뀐 새로운 문제가 나오면 전혀 손을 대지 못합니다. 학생 B는 문제를 100개만 풀었지만, 그 안에서 "이런 유형은 이렇게 접근한다"는 규칙과 원리를 이해했습니다. 처음 보는 문제라도 비슷한 유형이면 어느 정도 풀어낼 수 있습니다.
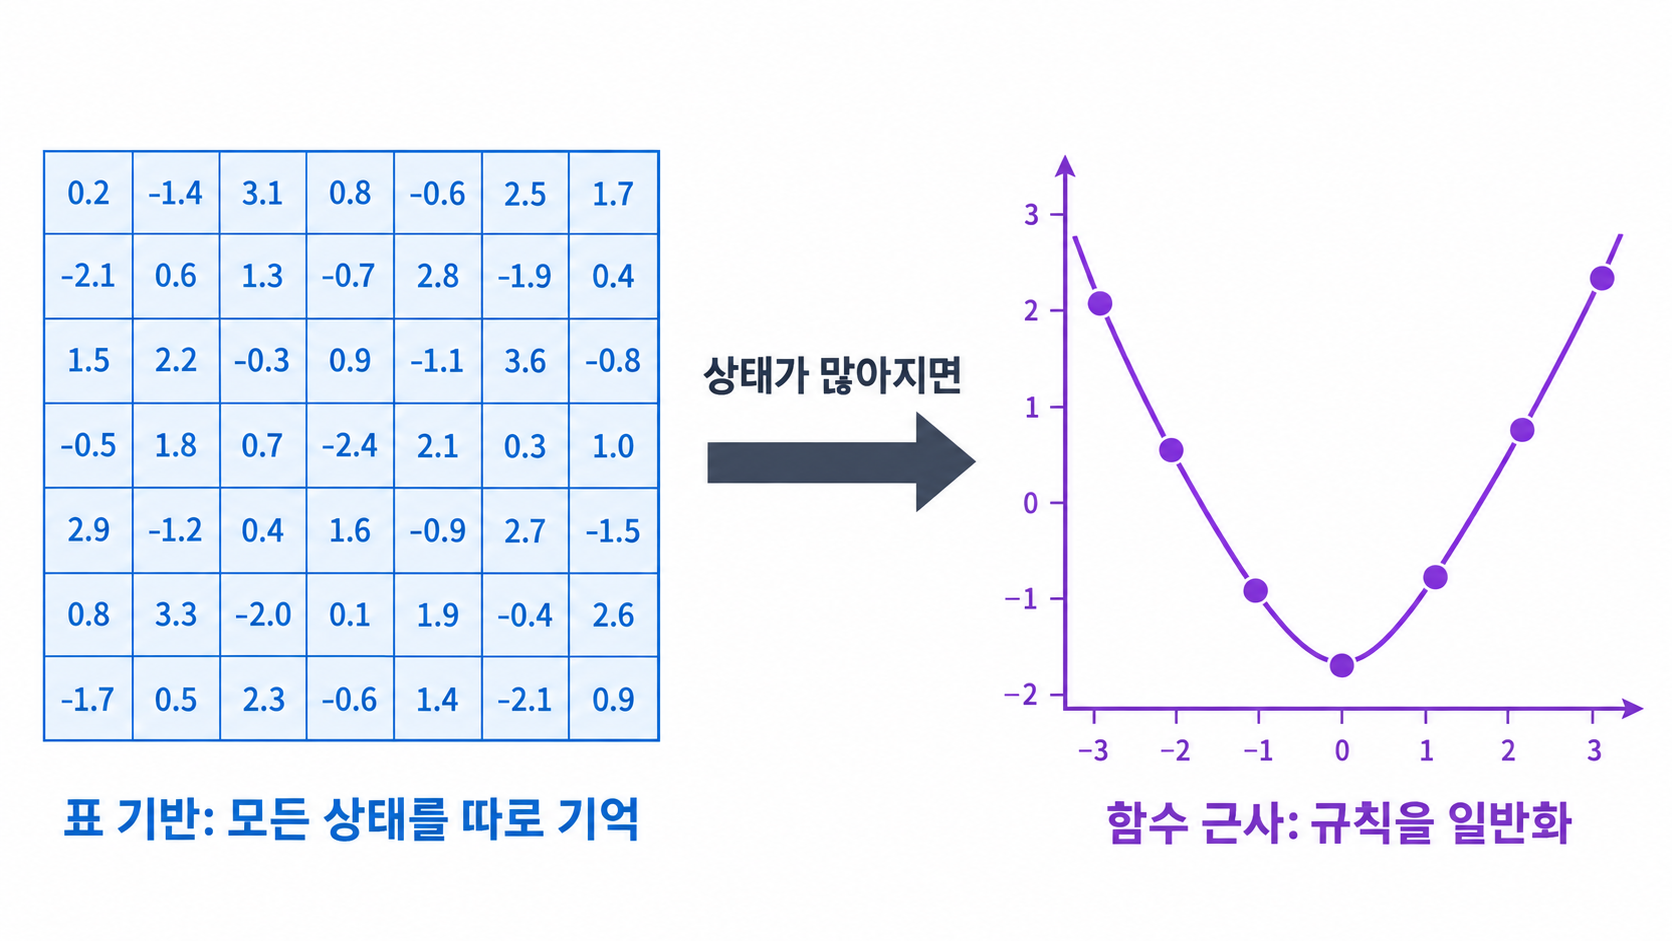
지금까지 글에서 다룬 표(table) 기반 방법들은 학생 A와 같습니다. $Q(s,a)$ 값을 상태-행동 쌍마다 개별 칸에 정확히 저장하고 기억합니다. 이 방법은 상태가 몇십, 몇백 개일 때는 잘 작동하지만, 상태가 수백만 개이거나(예: 체스판의 모든 배치) 심지어 연속적이어서 개수를 셀 수조차 없다면(예: 로봇 팔의 각도, 자동차의 속도) 표 자체를 만들 수 없습니다.
이번 글에서 배울 함수 근사(function approximation)는 학생 B처럼, 개별 상태를 낱낱이 외우는 대신 "특징(feature)"을 이용해 가치함수를 일반화된 함수로 표현합니다.
비유의 한계: 학생 비유는 "일반화 능력"이라는 개념을 잘 전달하지만, 실제 함수 근사는 사람처럼 원리를 "이해"하는 것이 아니라, 수학적으로 정의된 함수(선형함수 또는 신경망)의 파라미터를 데이터에 맞춰 조정하는 과정입니다. 또한 사람과 달리, 함수 근사는 학습에 사용된 데이터 분포와 많이 다른 새로운 상태에서는 예측이 크게 틀릴 수 있다는 한계가 있습니다(이 문제는 나중에 다룹니다).
상태 일반화가 필요한 이유
CartPole(막대 균형잡기) 환경을 생각해 봅시다. 상태는 카트의 위치, 속도, 막대의 각도, 각속도로 이루어진 4개의 실수입니다. 이 값들은 연속적이므로 "가능한 모든 상태의 개수"는 사실상 무한합니다. 표를 만들려면 각 값의 범위를 잘게 쪼개 칸을 나눠야 하는데(이를 이산화, discretization이라 합니다), 너무 잘게 쪼개면 칸의 개수가 폭발적으로 늘어나고, 너무 굵게 쪼개면 정보를 잃습니다. 함수 근사는 이런 이산화 없이, 연속적인 상태를 그대로 입력받아 가치를 출력하는 함수를 학습합니다.
특징 벡터와 선형 가치함수
가장 단순한 함수 근사는 상태 $s$를 특징 벡터(feature vector) $\mathbf{x}(s) = [x_1(s), x_2(s), \dots, x_n(s)]$로 변환한 뒤, 이 특징들의 가중합으로 가치를 추정하는 것입니다.
$$
\hat{V}(s; \mathbf{w}) = \mathbf{w}^\top \mathbf{x}(s) = \sum_{i=1}^{n} w_i x_i(s)
$$
이 식이 말하는 것은 가치 추정치는 각 특징에 가중치를 곱해 모두 더한 값입니다. 학습이란 결국 이 가중치 벡터 $\mathbf{w}$를 데이터에 맞게 조정하는 과정입니다. 이 가중치는 상태 개수가 아니라 "특징 개수"만큼만 필요하므로, 표 기반 방법보다 훨씬 적은 파라미터로 비슷한 상태들을 "공유"해서 표현할 수 있습니다(비슷한 특징을 가진 상태들은 비슷한 가치를 갖게 됨).
경사하강법으로 이 가중치를 갱신하는 규칙은 다음과 같습니다.
$$
\mathbf{w} \leftarrow \mathbf{w} + \alpha \Big[ G_t - \hat{V}(s_t; \mathbf{w}) \Big] \nabla_{\mathbf{w}} \hat{V}(s_t; \mathbf{w})
$$
이 식이 말하는 것은 "실제 목표값($G_t$ 또는 TD 목표값)과 현재 예측값의 차이"에 "그 예측값이 가중치에 대해 얼마나 민감하게 변하는지 (기울기)"를 곱해, 오차를 줄이는 방향으로 가중치를 조금씩 이동시킵니다. 선형함수의 경우 $\nabla_{\mathbf{w}} \hat{V}(s;\mathbf{w}) = \mathbf{x}(s)$이므로, 식이 단순해집니다.
신경망으로 확장하기
선형 함수는 "특징을 어떻게 설계하느냐"에 크게 의존합니다. 신경망은 이 특징 설계 과정 자체를 데이터로부터 학습합니다. 신경망 근사는 다음과 같이 표현됩니다.
$$
\hat{V}(s; \theta) = f_\theta(s)
$$
이 식이 말하는 것은 $\theta$는 신경망의 모든 가중치와 편향을 통칭하는 기호이고, $f_\theta$는 상태 $s$를 입력받아 가치를 출력하는 신경망 함수입니다. 선형함수와 원리는 같지만(예측과 목표값의 차이를 줄이는 방향으로 파라미터를 조정), 신경망은 여러 층의 비선형 변환을 거치므로 훨씬 복잡한 함수를 표현할 수 있습니다. 이 파라미터 조정은 PyTorch의 자동미분(autograd)이 대신 계산해 줍니다.
그림으로 이해하기
PyTorch 기초 복습
이번 글부터는 PyTorch를 본격적으로 사용합니다. 핵심 개념 세 가지만 짚고 넘어갑니다.
- 텐서(tensor): NumPy 배열과 비슷하지만, GPU에서 연산할 수 있고 자동미분을 지원하는 PyTorch의 기본 자료구조입니다.
- 자동미분(autograd):
loss.backward()를 호출하면 PyTorch가 손실함수부터 각 파라미터까지의 기울기(gradient)를 자동으로 계산해 줍니다. 사람이 미분 공식을 직접 유도할 필요가 없습니다. optimizer.step(): 계산된 기울기를 이용해 실제로 파라미터를 갱신하는 명령입니다.loss.backward()다음에 항상 호출됩니다.
100% 실행되는 코드
아래 코드는 Gymnasium의 MountainCar-v0(연속 상태를 가진 환경)에서, 매우 단순한 신경망으로 상태가치 $V(s)$를 근사하는 예제입니다. 아직 정책을 학습하는 것이 아니라, "연속 상태를 신경망에 넣어 가치를 예측하고, TD 오차로 학습시키는" 함수 근사 자체의 메커니즘을 보여주는 데 집중합니다.
"""
value_function_approximation.py — 8장. 표가 너무 커질 때: 함수 근사
CartPole-v1 환경에서 고정된 정책(막대가 기운 방향으로 미는 단순 규칙 정책)의
상태가치 V(s)를 작은 신경망으로 근사합니다 (TD(0) 기반 준경사도 예측).

검증 환경: Python 3.11.8, numpy 1.26.4, torch 2.3.1, gymnasium 0.29.1 (CPU)
실행: python value_function_approximation.py
예상 실행 시간: CPU에서 약 20~40초 (300 에피소드 기준)
예상 출력: 학습 손실(TD 오차 제곱)이 점차 감소하는 추세가 출력되고,
           artifacts/ch08/value_approx_loss.png에 학습 곡선이 저장됩니다.
"""

import os
import sys

import numpy as np
import torch
import torch.nn as nn
import gymnasium as gym

sys.path.append(os.path.join(os.path.dirname(__file__), "..", "common"))
from rl_utils import set_seed, save_curve  # noqa: E402


class ValueNetwork(nn.Module):
    """상태(4차원 벡터)를 입력받아 스칼라 가치 하나를 출력하는 작은 신경망.

    구조: 입력(4) -> 은닉층(64, ReLU) -> 은닉층(64, ReLU) -> 출력(1)
    """

    def __init__(self, state_dim: int, hidden_dim: int = 64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(state_dim, hidden_dim),
            nn.ReLU(),
            nn.Linear(hidden_dim, hidden_dim),
            nn.ReLU(),
            nn.Linear(hidden_dim, 1),
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        # x shape: [batch_size, state_dim] -> 출력 shape: [batch_size, 1]
        return self.net(x)


def heuristic_policy(state: np.ndarray) -> int:
    """CartPole을 위한 아주 단순한 규칙 기반 정책: 막대가 기운 방향으로 카트를 민다.
    (아직 학습된 정책이 아니라, "이 정책의 가치를 함수 근사로 추정"하는 예측 문제에
    집중하기 위해 고정된 정책을 사용합니다.)
    state[2]는 막대의 각도(라디안): 양수면 오른쪽으로 기운 것.
    """
    pole_angle = state[2]
    return 1 if pole_angle > 0 else 0  # 0=왼쪽 밀기, 1=오른쪽 밀기


def main() -> None:
    set_seed(0)
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    print(f"사용 장치: {device}")

    env = gym.make("CartPole-v1")
    state_dim = env.observation_space.shape[0]  # 4

    value_net = ValueNetwork(state_dim).to(device)
    optimizer = torch.optim.Adam(value_net.parameters(), lr=1e-3)
    gamma = 0.99

    n_episodes = 300
    episode_losses = []

    for ep in range(1, n_episodes + 1):
        state, _ = env.reset(seed=ep)  # 매 에피소드 다른 초기 상태 (재현성을 위해 결정적 seed)
        terminated = truncated = False
        losses_this_ep = []

        while not (terminated or truncated):
            action = heuristic_policy(state)
            next_state, reward, terminated, truncated, _ = env.step(action)

            # 상태를 텐서로 변환. shape: [1, state_dim] (배치 크기 1)
            state_tensor = torch.tensor(state, dtype=torch.float32, device=device).unsqueeze(0)
            next_state_tensor = torch.tensor(next_state, dtype=torch.float32, device=device).unsqueeze(0)

            # TD 목표값 계산 시에는 다음 상태 가치에 대한 기울기가 필요 없으므로 no_grad 사용
            with torch.no_grad():
                next_value = 0.0 if terminated else value_net(next_state_tensor).item()
            td_target = reward + gamma * next_value
            td_target_tensor = torch.tensor([[td_target]], dtype=torch.float32, device=device)

            predicted_value = value_net(state_tensor)  # shape: [1, 1], 기울기 필요
            loss = nn.functional.mse_loss(predicted_value, td_target_tensor)

            optimizer.zero_grad()
            loss.backward()
            optimizer.step()

            losses_this_ep.append(loss.item())
            state = next_state

        episode_losses.append(float(np.mean(losses_this_ep)))

        if ep % 50 == 0:
            recent_avg = np.mean(episode_losses[-50:])
            print(f"[에피소드 {ep:3d}] 최근 50개 평균 손실: {recent_avg:.4f}")

    os.makedirs("artifacts/ch08", exist_ok=True)
    save_curve(
        episode_losses,
        title="함수 근사 학습 손실 (TD 오차 제곱)",
        ylabel="평균 손실",
        out_path="artifacts/ch08/value_approx_loss.png",
        window=20,
    )

    # 학습된 가치함수가 그럴듯한지 간단히 확인: 막대가 거의 세워진 상태의 가치가
    # 많이 기운 상태보다 높게 나오는지 확인
    with torch.no_grad():
        upright_state = torch.tensor([[0.0, 0.0, 0.01, 0.0]], dtype=torch.float32, device=device)
        tilted_state = torch.tensor([[0.0, 0.0, 0.15, 0.0]], dtype=torch.float32, device=device)
        v_upright = value_net(upright_state).item()
        v_tilted = value_net(tilted_state).item()

    print(f"\n거의 세워진 상태(각도=0.01)의 추정 가치: {v_upright:.3f}")
    print(f"많이 기운 상태(각도=0.15)의 추정 가치     : {v_tilted:.3f}")
    print("(막대가 덜 기운 상태의 가치가 더 높게 나온다면, 신경망이 '균형이 좋을수록")
    print(" 오래 버틴다'는 CartPole의 구조를 어느 정도 학습했다는 뜻입니다.)")

    env.close()


if __name__ == "__main__":
    main()
예상 출력 예시:
사용 장치: cpu
[에피소드  50] 최근 50개 평균 손실: 18.1742
[에피소드 100] 최근 50개 평균 손실: 16.6259
[에피소드 150] 최근 50개 평균 손실: 16.2528
[에피소드 200] 최근 50개 평균 손실: 14.6919
[에피소드 250] 최근 50개 평균 손실: 13.6567
[에피소드 300] 최근 50개 평균 손실: 12.6189

거의 세워진 상태(각도=0.01)의 추정 가치: 32.222
많이 기운 상태(각도=0.15)의 추정 가치     : 30.061
(막대가 덜 기운 상태의 가치가 더 높게 나온다면, 신경망이 '균형이 좋을수록
 오래 버틴다'는 CartPole의 구조를 어느 정도 학습했다는 뜻입니다.)
이 예제는 고정된 규칙 기반 정책의 "가치"만 예측하는 것이 목표이므로, 손실이 0에 완전히 수렴하지 않고 어느 정도 수준에서 서서히 줄어드는 정도로도 충분합니다(정책 자체가 최적이 아니므로 가치 추정도 그 정책 기준으로만 정확하면 됩니다). 손실 값 자체는 보상 스케일과 에피소드 길이에 따라 상당히 클 수 있습니다 — CartPole은 매 스텝 +1의 보상을 계속 누적하므로, 오래 버티는 에피소드일수록 가치 자체가 커지고, 그만큼 TD 오차 제곱(손실)의 절대적인 크기도 커질 수 있습니다. 중요한 것은 절대값보다 "300 에피소드에 걸쳐 손실이 꾸준히 줄어드는 추세"와 "각도가 작을 때(거의 세워짐)의 가치가 각도가 클 때(많이 기욺)보다 높다"는 경향이며, 이 두 가지는 안정적으로 재현됩니다.
코드를 한 줄씩 이해하기
ValueNetwork:nn.Sequential로 층을 순서대로 쌓았습니다. 입력 shape는[batch_size, 4], 출력 shape는[batch_size, 1]입니다.ReLU는 비선형성을 추가해 신경망이 단순한 직선(선형 함수)보다 복잡한 형태의 함수를 표현할 수 있게 해줍니다.state_tensor = ...unsqueeze(0):state는 원래 shape가(4,)인 1차원 배열입니다. 신경망은 배치 단위 입력([batch_size, 4])을 기대하므로,unsqueeze(0)으로 맨 앞에 배치 차원을 추가해 shape를(1, 4)로 만듭니다.with torch.no_grad(): next_value = ...: TD 목표값을 계산할 때는 "다음 상태의 가치"가 기울기 계산에 참여하면 안 됩니다(목표값은 고정된 숫자로 취급해야 하며, 그렇지 않으면 목표값 자체가 학습 대상이 되어버려 학습이 불안정해집니다).no_grad()는 이 블록 안의 연산이 기울기를 추적하지 않도록 명시적으로 막습니다.optimizer.zero_grad()→loss.backward()→optimizer.step(): PyTorch 학습의 표준 3단계입니다. 기울기를 0으로 초기화하고(이전 스텝의 기울기가 남아있지 않도록), 역전파로 기울기를 계산하고, 그 기울기로 파라미터를 갱신합니다.heuristic_policy: 이번 글의 예제는 "정책을 학습하는 것"이 아니라 "주어진 정책의 가치를 함수 근사로 추정하는 것"에 집중하므로, 정책 자체는 아주 단순한 규칙(막대가 기운 방향으로 밀기)으로 고정했습니다.
직접 바꾸어 보는 실험
ValueNetwork의 은닉층 크기를 64에서 8로 줄이면 학습 손실이 어떻게 달라지는지 관찰해보세요. 너무 작은 신경망은 무엇을 놓치게 될까요?- 학습률(
lr)을 1e-3에서 1e-1로 크게 높이면 손실 곡선이 어떻게 달라지나요? (힌트: 학습이 불안정해지거나 발산할 수 있습니다.) heuristic_policy를 "항상 오른쪽으로 밀기"처럼 훨씬 나쁜 정책으로 바꾸면, 학습된 가치 추정치의 절대적인 크기가 어떻게 달라지는지 확인해보세요.
자주 하는 실수
no_grad()없이 다음 상태 가치를 계산하는 경우: 목표값 계산에 기울기가 흘러 들어가면, 신경망이 "목표값 자체도 움직이는" 이상한 방식으로 학습하게 되어 불안정해집니다. 이 문제는 다음 글에서 배울 DQN의 타깃 네트워크에서 더 정교하게 다뤄집니다.- 텐서의 shape을 확인하지 않고 넘어가는 경우:
unsqueeze(0)을 빠뜨리면[4]와[1, 4]의 차원 불일치로 오류가 나거나, 조용히 잘못된 계산이 이루어질 수 있습니다. 새 텐서를 만들 때마다 shape을 주석으로 남기는 습관을 들이는 것이 좋습니다. loss.item()을 남발해 불필요하게 GPU-CPU 데이터 전송이 발생하는 경우: 학습 루프 안에서 로그를 남기기 위해.item()을 호출하는 것은 괜찮지만, 텐서 자체를 계속 CPU로 옮기며 연산하면(예: 매 스텝마다 NumPy로 변환했다가 다시 텐서로 변환) 불필요하게 느려질 수 있습니다.
다음으로
이번 글에서는 "고정된 정책의 가치를 신경망으로 예측"하는 것까지만 다뤘습니다. 다음 글에서는 이 아이디어를 확장해, 신경망이 예측한 행동가치 $Q(s,a)$를 이용해 실제로 좋은 행동을 선택하고, 그 경험으로 신경망 자체를 계속 개선해나가는 완전한 강화학습 알고리즘인 DQN(Deep Q-Network)을 배웁니다. DQN은 Atari 게임을 사람 수준으로 플레이해 딥러닝과 강화학습의 결합을 세상에 알린 역사적인 알고리즘이고 알파고(AlphaGo)에 사용된 것으로 잘 알려져 있습니다.
'머신러닝' 카테고리의 다른 글
| 강화학습 9 - DQN: 화면을 보고 행동을 고르는 신경망 (0) | 2026.10.19 |
|---|---|
| 강화학습 7 - SARSA와 Q-learning (0) | 2026.10.15 |
| 강화학습 6 - 시간차 학습 (기다리지 않고 배우기) (0) | 2026.09.30 |
| 강화학습 5 - 몬테카를로 (끝까지 경험하고 배우기) (0) | 2026.09.30 |
| 강화학습 4 - 동적 계획법 (환경을 알 때) (0) | 2026.09.27 |