"Random Forest나 XGBoost처럼 강력한 트리 기반 모델도 불균형 데이터에서 별도의 조치가 필요할까?"
지금까지는 주로 Logistic Regression과 SVM 같은 선형/커널 기반 모델로 실험했습니다. 이번 글에서는 실무에서 가장 널리 쓰이는 트리 앙상블 모델들이 불균형 데이터를 어떻게 다루는지, 그리고 이들 모델 전용의 불균형 대응 기법을 살펴봅니다.
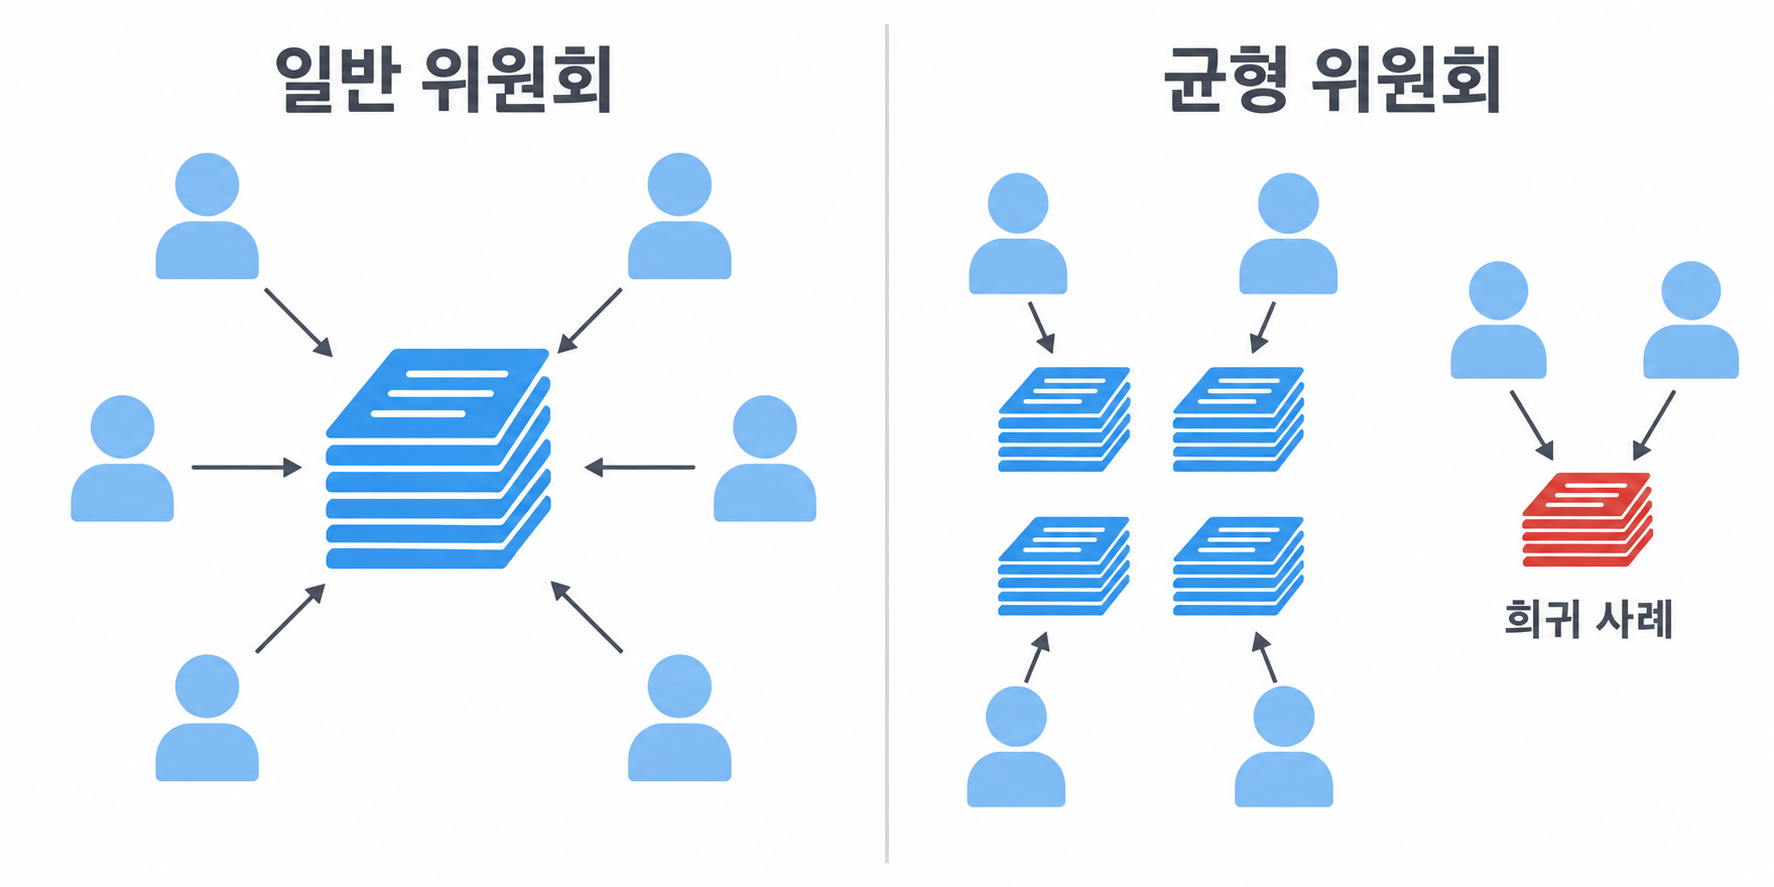
여러 전문가로 구성된 위원회, 그중 일부는 희귀 사례만 집중적으로 검토
병원의 진단 위원회에 의사 100명이 있다고 상상해봅시다. 일반적인 위원회라면 모든 의사가 모든 환자 기록을 골고루 검토합니다. 하지만 희귀 질환처럼 극히 드문 사례를 잘 잡아내려면, 일부 의사 그룹은 오직 희귀 질환이 의심되는 사례만 집중적으로 훈련받고 검토하도록 역할을 나눌 수도 있습니다. Balanced Random Forest나 EasyEnsemble 같은 기법은 이처럼 앙상블을 구성하는 각 "위원(트리 또는 서브모델)"이 보게 되는 데이터 자체를 균형 있게 조정하는 아이디어입니다.
Random Forest, Balanced Random Forest, EasyEnsemble
- Random Forest: 여러 결정 트리를 부트스트랩 샘플로 학습시켜 평균/다수결로 예측하는 기본 앙상블. 별도 조치 없이도 어느 정도 불균형에 강건한 편이지만, 극단적인 불균형에서는 여전히 다수 클래스에 치우칠 수 있다.
- Balanced Random Forest: 각 트리를 학습시킬 때 사용하는 부트스트랩 샘플을 뽑는 과정에서, 다수 클래스와 소수 클래스의 개수를 균형 있게 맞춰서 추출한다. 즉, 이전 글의 언더샘플링을 "트리 하나하나를 만들 때마다" 반복하는 셈이다.
- EasyEnsemble: 다수 클래스를 여러 개의 균형 잡힌 부분집합으로 나누고, 각 부분집합으로 별도의 분류기(주로 AdaBoost)를 학습시킨 뒤 그 결과를 앙상블한다. 다수 클래스의 정보를 여러 서브모델에 나누어 담기 때문에 Balanced Random Forest보다 다수 클래스 정보 손실이 적을 것으로 기대되지만, 실제 효과는 데이터에 따라 다르다.
XGBoost의 scale_pos_weight, LightGBM의 관련 옵션
부스팅 계열 모델들은 클래스 가중치를 손실함수에 직접 반영하는 파라미터를 제공합니다.
- XGBoost: scale_pos_weight 파라미터에 "다수 클래스 개수 / 소수 클래스 개수" 비율을 넣으면, 양성 클래스(보통 소수 클래스로 지정)의 손실 기여도를 그 비율만큼 키운다.
- LightGBM: is_unbalance=True 옵션이나 scale_pos_weight 파라미터로 유사한 효과를 낼 수 있다.
두 옵션 모두 이전 글에서 배운 class_weight와 원리는 같지만, 부스팅 모델의 손실함수(그래디언트) 계산 방식에 맞춰 적용된다는 차이가 있습니다.
가중치 조정과 확률 보정은 별개의 문제
이번 글에서 반드시 기억해야 할 구분입니다. scale_pos_weight나 클래스 가중치를 조정하면 모델이 소수 클래스를 더 적극적으로 예측하게 되지만, 그 결과로 나온 예측 확률값 자체는 더 이상 실제 발생 확률을 의미하지 않게 될 수 있습니다. 예를 들어 모델이 "이 거래가 사기일 확률 0.8"이라고 출력해도, 가중치 조정의 영향으로 실제 사기 비율은 그보다 훨씬 낮을 수 있습니다. 확률을 신뢰할 수 있게 만드는 방법은 나중에 확률 보정에서 별도로 다룹니다.
작은 숫자 예제
다수 클래스 2,850개, 소수 클래스 150개 데이터에서 XGBoost의 scale_pos_weight를 계산하면:
scale_pos_weight = 다수 클래스 개수 / 소수 클래스 개수 = 2850 / 150 = 19.0
이 값을 파라미터로 넣으면, 부스팅 과정에서 소수 클래스 샘플 하나의 그래디언트(오류 신호)가 다수 클래스 샘플 하나보다 19배 크게 반영됩니다.
Python 실습: 베이스라인과 앙상블 모델을 동일 교차검증으로 비교
# 설치가 필요한 환경에서 한 번만 실행
# !pip install -q scikit-learn imbalanced-learn xgboost lightgbm numpy

import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import StratifiedKFold, cross_val_score
from sklearn.ensemble import RandomForestClassifier
from imblearn.ensemble import BalancedRandomForestClassifier, EasyEnsembleClassifier
import xgboost as xgb
import lightgbm as lgb

RANDOM_STATE = 42
np.random.seed(RANDOM_STATE)

X, y = make_classification(
    n_samples=3000,
    n_features=10,
    n_informative=5,
    n_redundant=2,
    weights=[0.95, 0.05],
    class_sep=1.0,
    random_state=RANDOM_STATE,
)

n_pos = np.sum(y == 1)
n_neg = np.sum(y == 0)
scale_pos_weight = n_neg / n_pos
print(f"클래스 분포: 다수={n_neg}, 소수={n_pos}, scale_pos_weight={scale_pos_weight:.4f}")
print("-" * 60)

cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=RANDOM_STATE)

models = {
    "RandomForest (baseline)": RandomForestClassifier(
        n_estimators=200, random_state=RANDOM_STATE
    ),
    "BalancedRandomForest": BalancedRandomForestClassifier(
        n_estimators=200, random_state=RANDOM_STATE,
        sampling_strategy="all", replacement=True,
    ),
    "EasyEnsemble": EasyEnsembleClassifier(
        n_estimators=20, random_state=RANDOM_STATE
    ),
    "XGBoost (baseline)": xgb.XGBClassifier(
        n_estimators=200, random_state=RANDOM_STATE, eval_metric="logloss"
    ),
    "XGBoost (scale_pos_weight)": xgb.XGBClassifier(
        n_estimators=200, random_state=RANDOM_STATE, eval_metric="logloss",
        scale_pos_weight=scale_pos_weight,
    ),
    "LightGBM (baseline)": lgb.LGBMClassifier(
        n_estimators=200, random_state=RANDOM_STATE, verbosity=-1
    ),
    "LightGBM (is_unbalance)": lgb.LGBMClassifier(
        n_estimators=200, random_state=RANDOM_STATE, verbosity=-1, is_unbalance=True
    ),
}

for name, model in models.items():
    scores = cross_val_score(model, X, y, cv=cv, scoring="f1")
    print(f"{name:30s} F1 평균: {scores.mean():.4f}")
실제 실행 결과:
클래스 분포: 다수=2850, 소수=150, scale_pos_weight=19.0000
------------------------------------------------------------
RandomForest (baseline)       F1 평균: 0.4562
BalancedRandomForest          F1 평균: 0.4547
EasyEnsemble                  F1 평균: 0.2154
XGBoost (baseline)            F1 평균: 0.5550
XGBoost (scale_pos_weight)    F1 평균: 0.5736
LightGBM (baseline)           F1 평균: 0.5328
LightGBM (is_unbalance)       F1 평균: 0.5348
이번 실습에서는 앞선 글들과 다른, 훨씬 더 고무적인 패턴이 나타납니다.
첫째, 부스팅 계열 모델(XGBoost, LightGBM)의 베이스라인 F1(0.53~0.56)이 앞서 앞에서 다룬 선형 모델들의 베이스라인 F1(0.34)보다 훨씬 높습니다. 이는 트리 기반 부스팅 모델이 비선형 결정경계를 유연하게 학습할 수 있어, 애초에 불균형 데이터에 대해 더 강건한 경향이 있음을 보여줍니다.
둘째, XGBoost에 scale_pos_weight를 적용하자 F1이 실제로 개선되었습니다(0.5550 → 0.5736). 이는 이 책에서 지금까지 다룬 기법 중 베이스라인 대비 뚜렷한 개선을 보인 몇 안 되는 사례입니다. LightGBM의 is_unbalance 역시 미세하지만 긍정적인 방향(0.5328 → 0.5348)으로 움직였습니다.
셋째, EasyEnsemble은 오히려 가장 낮은 F1(0.2154)을 기록했습니다. 다수 클래스를 여러 균형 부분집합으로 나누는 과정에서, 각 서브모델이 학습하는 다수 클래스 정보가 지나치게 단순화되었을 가능성이 있습니다. Balanced Random Forest는 baseline Random Forest와 거의 차이가 없었습니다(0.4562 vs 0.4547).
종합하면, "모델 내부에 이미 비선형성과 앙상블 구조를 가진 강력한 모델(부스팅)일수록, 소수 클래스에 최적화된 손실 가중치 조정이 실제로 도움이 될 가능성이 크다"는 것이 이번 글의 핵심 발견입니다. 반대로 데이터 자체를 잘게 쪼개 여러 서브모델에 나누어 학습시키는 방식(EasyEnsemble)은 이 데이터에서는 오히려 역효과를 냈습니다.
흔한 실수
- 트리 앙상블이므로 불균형 문제에 자동으로 강건할 것이라 가정하고 아무 조치도 취하지 않는 것. 베이스라인 대비 개선 여지가 있는지 항상 확인해야 한다.
- scale_pos_weight 값을 임의로 크게 설정하는 것. "다수/소수 비율"이라는 이론적 기준값에서 출발해 실제 검증 성능을 보며 미세 조정하는 것이 안전하다.
- 가중치를 높여 Recall이 개선된 것을 보고 확률값도 신뢰할 수 있다고 착각하는 것. 앞서 강조했듯 가중치 조정과 확률 보정은 별개의 문제이며, 확률을 실제 의사결정(예: 조사 우선순위 산정)에 쓰려면 후에 다룰 보정 절차가 필요하다.
- 여러 앙상블 기법을 검증 없이 "최신 기법이니까 더 낫다"는 가정으로 선택하는 것. 이번 글의 EasyEnsemble 사례처럼 오히려 성능이 낮을 수 있다.
한 걸음 더: 왜 부스팅 모델은 불균형에 상대적으로 강건한가?
부스팅 알고리즘은 이전 단계에서 잘못 예측한 샘플에 더 집중해서 다음 트리를 학습시키는 순차적 구조를 가집니다. 소수 클래스 샘플은 애초에 다수 클래스보다 잘못 예측되기 쉬우므로, 이 구조 자체가 어느 정도 "소수 클래스에 자연스럽게 더 집중하는" 효과를 냅니다. scale_pos_weight나 is_unbalance 같은 옵션은 이 자연스러운 경향을 한 단계 더 명시적으로 강화하는 역할을 합니다. 이런 이유로 실무에서 표 형태(정형) 데이터의 불균형 분류 문제를 다룰 때, 부스팅 계열 모델을 먼저 강력한 베이스라인으로 채택하고 그 위에 가중치를 미세 조정하는 전략이 널리 쓰입니다.
더 알아보기: 가중치를 준 모델을 SHAP으로 해석하기
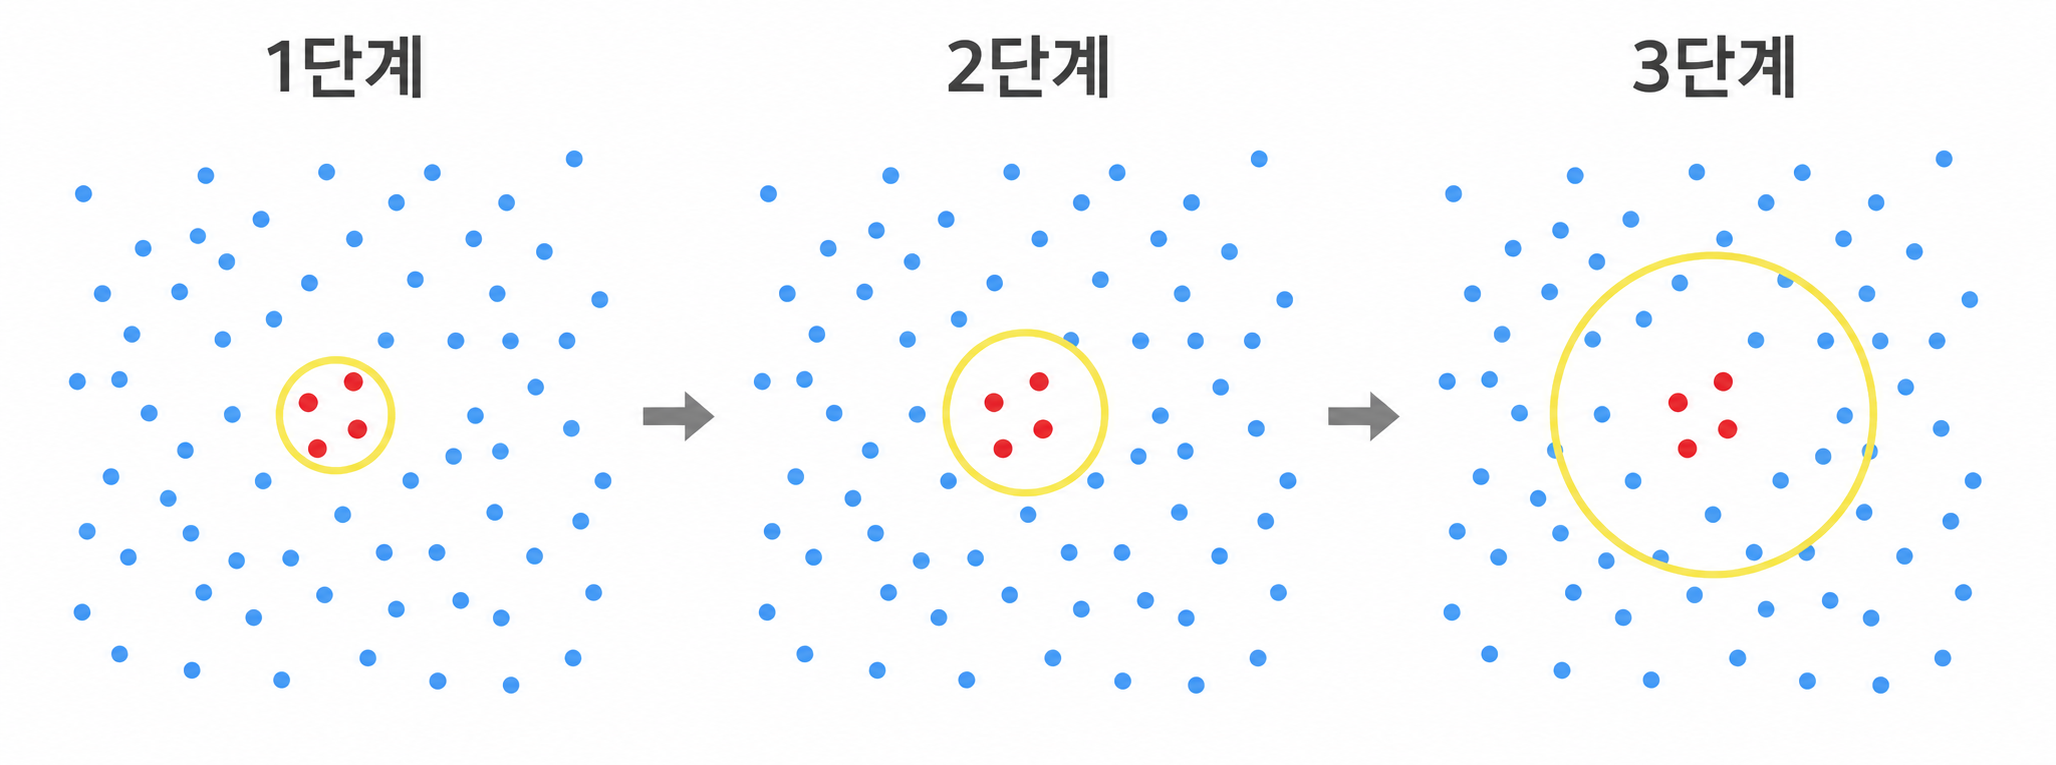
실무에서 사기 탐지 모델을 배포하면 반드시 따라오는 질문이 있습니다. "왜 이 거래를 사기로 판단했나요?" 정확도나 F1만으로는 이 질문에 답할 수 없습니다. SHAP(SHapley Additive exPlanations)은 게임이론의 섀플리 값 개념을 이용해, 각 예측에 대해 "어떤 특징이 얼마나 그 예측에 기여했는가"를 계산해주는 대표적인 모델 해석 도구입니다.
하지만, 불균형 데이터에서 SHAP을 사용할 때 특별히 주의할 점이 있습니다. scale_pos_weight나 class_weight로 가중치를 준 모델은, 가중치를 주지 않은 모델과 같은 특징이라도 그 특징이 예측에 기여하는 정도(SHAP 값)가 달라질 수 있습니다. 가중치가 소수 클래스 쪽으로 결정경계를 이동시키면서, 특정 특징이 "사기 쪽으로 얼마나 강하게 밀어붙이는가"에 대한 모델의 판단 기준 자체가 바뀌기 때문입니다. 따라서 가중치 적용 전후의 SHAP 요약 플롯(summary plot)을 비교해보면, 가중치 조정이 단순히 임곗값을 옮긴 것인지 아니면 모델이 특징을 활용하는 방식 자체를 바꾼 것인지 확인하는 데 도움이 됩니다.
간단한 사용 예시는 다음과 같습니다.
# 설치가 필요한 환경에서 한 번만 실행
# !pip install -q shap scikit-learn xgboost numpy

import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
import xgboost as xgb
import shap

RANDOM_STATE = 42
X, y = make_classification(
    n_samples=3000, n_features=10, n_informative=5, n_redundant=2,
    weights=[0.95, 0.05], class_sep=1.0, random_state=RANDOM_STATE,
)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=RANDOM_STATE
)

# scale_pos_weight를 적용한 모델을 직접 학습 (앞선 실습의 모델을 재사용해도 무방)
n_pos, n_neg = np.sum(y_train == 1), np.sum(y_train == 0)
xgb_weighted = xgb.XGBClassifier(
    n_estimators=200, random_state=RANDOM_STATE, eval_metric="logloss",
    scale_pos_weight=n_neg / n_pos,
)
xgb_weighted.fit(X_train, y_train)

explainer = shap.TreeExplainer(xgb_weighted)
shap_values = explainer.shap_values(X_test)

# 개별 예측 하나에 대한 설명: 어떤 특징이 사기 판정에 기여했는지
shap.force_plot(explainer.expected_value, shap_values[0], X_test[0], matplotlib=True)

# 전체 특징의 평균적인 중요도 요약
shap.summary_plot(shap_values, X_test, show=False)
참고: shap.force_plot은 기본적으로 인터랙티브 HTML을 반환합니다. Jupyter 밖에서 정적 이미지로 저장하려면 위 예시처럼 matplotlib=True를 지정하세요.
SHAP 값은 "이 모델이 왜 이렇게 예측했는가"를 설명할 뿐, "이 예측이 옳은가"를 보장하지는 않는다는 점도 함께 기억해야 합니다. 해석 가능성과 정확성은 서로 다른 축입니다.
'머신러닝' 카테고리의 다른 글
| 불균형 데이터 다루기 15 - 이상 탐지와 One-Class 접근법 (0) | 2026.09.14 |
|---|---|
| 불균형 데이터 다루기 14 - 딥러닝의 가중 손실과 Focal Loss (1) | 2026.09.14 |
| 불균형 데이터 다루기 12 - 클래스 가중치와 비용 민감 학습 (0) | 2026.09.13 |
| 불균형 데이터 다루기 11 - 잡음과 경계를 다듬는 하이브리드 샘플링 (0) | 2026.09.13 |
| 불균형 데이터 다루기 10 - SMOTE와 합성 샘플링의 원리 (0) | 2026.09.13 |