"기존 샘플을 복제하는 대신, 진짜 있을 법한 '새로운' 소수 클래스 샘플을 만들어낼 수 있을까?"
이전 글에서 확인했듯, 단순 복제는 특징 공간(feature space)에 새로운 정보를 더하지 못합니다. 이번 글에서는 기존 소수 클래스 샘플들 사이를 이어 그럴듯한 가상의 새 샘플을 만들어내는 기법, SMOTE를 다룹니다.
이미 있는 사례들 사이에서 그럴듯한 중간 사례를 상상하기
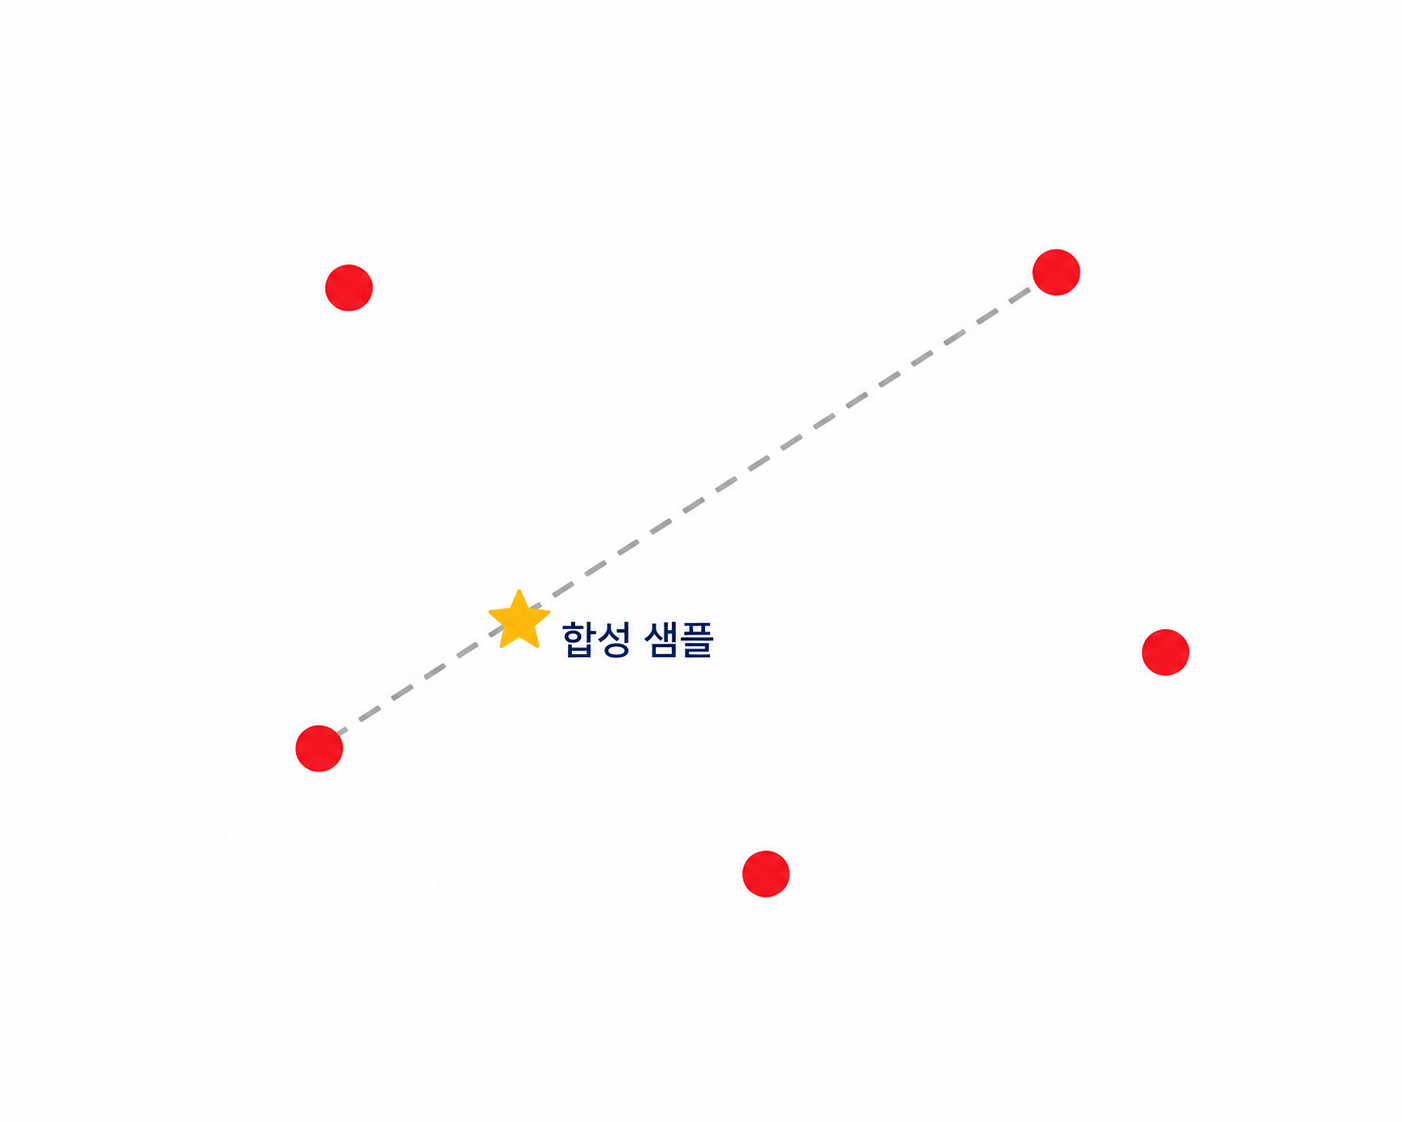
친구 두 명이 각각 "회사까지 걸어서 20분", "회사까지 걸어서 40분" 걸리는 곳에 산다고 말했습니다. 이 둘 사이 어딘가, 예를 들어 "걸어서 28분 걸리는 곳에 사는 사람"이 존재한다고 상상하는 것은 꽤 합리적입니다. 실제로 그런 사람을 본 적은 없지만, 두 사례 사이를 자연스럽게 이어보면 있을 법한 사례이기 때문입니다. SMOTE(Synthetic Minority Over-sampling Technique)는 정확히 이런 방식으로, 기존 소수 클래스 샘플 두 개를 골라 그 사이의 한 지점에 새로운 가상 샘플을 만듭니다.
SMOTE 알고리즘의 단계
- 소수 클래스 샘플 하나(x_i)를 선택한다.
- x_i의 k-최근접 이웃(같은 소수 클래스 내에서) 중 하나(x_zi)를 무작위로 선택한다.
- 0과 1 사이의 난수 λ를 뽑는다.
- 다음 식으로 새로운 샘플을 만든다.
x_new = x_i + λ × (x_zi − x_i), λ ∈ [0, 1]
이 식은 x_i와 x_zi를 잇는 직선 위의 한 점을 만드는 선형 보간(linear interpolation)입니다. λ=0이면 x_i 자신, λ=1이면 x_zi 자신이 되고, 그 사이 값이면 둘 사이의 새로운 좌표가 됩니다.
SMOTE 계열 변형
| 기법 | 핵심 아이디어 |
|---|---|
| SMOTE | 모든 소수 클래스 샘플에 대해 균등하게 보간 샘플을 생성 |
| Borderline-SMOTE | 다수 클래스와 경계에 가까운("위험한") 소수 샘플 주변에서 집중적으로 생성 |
| ADASYN | 분류하기 어려운(다수 클래스 이웃이 많은) 소수 샘플일수록 더 많은 합성 샘플을 생성 |
| SMOTENC | 수치형과 범주형 변수가 섞인 데이터에서, 범주형 변수는 최빈값으로 처리하며 보간 |
범주형·고차원·잡음 데이터에서의 한계
- 범주형 변수: "선형 보간"은 순서가 있는 연속형 변수에서만 자연스러운 의미를 가집니다. 범주형 변수(예: 지역 코드, 회원 등급)에 일반 SMOTE를 적용하면 존재하지 않는 값(예: 1.5번 지역)이 만들어질 수 있습니다. 이런 경우 SMOTENC나 SMOTEN을 사용해야 합니다.
- 고차원 데이터: 차원이 매우 높아지면 "최근접 이웃"이라는 개념 자체가 흐려지는 차원의 저주(curse of dimensionality) 문제가 발생합니다. 모든 점들 사이의 거리가 비슷해져, 보간이 실제로 의미 있는 이웃 사이에서 이루어지는지 확신하기 어려워집니다.
- 잡음 데이터: 원본 소수 클래스 샘플 중 라벨이 잘못된(잡음) 샘플이 있다면, SMOTE는 그 잘못된 샘플 주변에도 성실하게 새로운 샘플을 만들어냅니다. 즉 잡음도 함께 증폭시킬 수 있습니다.
작은 숫자 예제
2차원 특징 공간에 소수 클래스 샘플이 5개 있습니다: (2.0, 3.0), (2.5, 4.0), (3.0, 2.5), (4.0, 5.0), (1.5, 2.0). 첫 번째 샘플 x_i = (2.0, 3.0)의 최근접 이웃은 x_zi = (2.5, 4.0)입니다. λ = 0.3을 뽑았다면:
x_new = (2.0, 3.0) + 0.3 × ((2.5, 4.0) − (2.0, 3.0))
      = (2.0, 3.0) + 0.3 × (0.5, 1.0)
      = (2.0 + 0.15, 3.0 + 0.3)
      = (2.15, 3.3)
이렇게 만들어진 (2.15, 3.3)은 원본 데이터에는 없던 완전히 새로운 좌표이지만, 기존 두 샘플이 있던 영역 안에 자연스럽게 위치합니다.
Python 실습: 2차원 데이터에서 SMOTE 보간 과정을 단계별로 구현
# 설치가 필요한 환경에서 한 번만 실행
# !pip install -q scikit-learn imbalanced-learn numpy

import numpy as np
from sklearn.neighbors import NearestNeighbors

RANDOM_STATE = 42
rng = np.random.default_rng(RANDOM_STATE)

# 소수 클래스 샘플 5개 (앞선 숫자 예제와 동일)
minority = np.array([
    [2.0, 3.0],
    [2.5, 4.0],
    [3.0, 2.5],
    [4.0, 5.0],
    [1.5, 2.0],
])

def manual_smote(minority_points, n_synthetic, k_neighbors=2, rng=None):
    """SMOTE 알고리즘을 처음부터 직접 구현한 버전.
    k_neighbors=2로 설정하면 자기 자신을 포함해 2개를 찾으므로 실제 이웃은 1개다."""
    if rng is None:
        rng = np.random.default_rng()

    nn = NearestNeighbors(n_neighbors=k_neighbors).fit(minority_points)
    _, indices = nn.kneighbors(minority_points)

    synthetic_samples = []
    for _ in range(n_synthetic):
        i = rng.integers(0, len(minority_points))          # 기준 샘플 무작위 선택
        neighbor_choices = indices[i][1:]                  # 자기 자신을 제외한 이웃들
        zi = rng.choice(neighbor_choices)                  # 이웃 중 하나 무작위 선택
        lam = rng.uniform(0, 1)                             # 보간 비율

        x_i = minority_points[i]
        x_zi = minority_points[zi]
        x_new = x_i + lam * (x_zi - x_i)
        synthetic_samples.append(x_new)

    return np.array(synthetic_samples)

synthetic = manual_smote(minority, n_synthetic=10, k_neighbors=2, rng=rng)
print("원본 소수 클래스 샘플:\n", minority)
print("\n생성된 합성 샘플 10개:\n", np.round(synthetic, 3))

# scikit-learn/imbalanced-learn의 실제 SMOTE와 결과 비교 (실전 데이터로 검증)
from sklearn.datasets import make_classification
from imblearn.over_sampling import SMOTE

X, y = make_classification(
    n_samples=1000, n_features=2, n_informative=2, n_redundant=0,
    n_clusters_per_class=1, weights=[0.9, 0.1], class_sep=1.2,
    random_state=RANDOM_STATE,
)
print("\n[실전 데이터] 원본 분포:", np.bincount(y))

smote = SMOTE(random_state=RANDOM_STATE, k_neighbors=5)
X_res, y_res = smote.fit_resample(X, y)
print("[실전 데이터] SMOTE 적용 후 분포:", np.bincount(y_res))
실제 실행 결과(요약):
원본 소수 클래스 샘플:
 [[2.  3. ]
  [2.5 4. ]
  [3.  2.5]
  [4.  5. ]
  [1.5 2. ]]

생성된 합성 샘플 10개: (실행 시 무작위로 λ가 뽑히므로 매번 조금씩 다른 좌표가 나오지만
모두 원본 5개 점 사이의 직선 위에 위치한다)

[실전 데이터] 원본 분포: [900 100]
[실전 데이터] SMOTE 적용 후 분포: [900 900]
이제 SMOTE 계열 기법들이 실제 분류 성능에 미치는 영향을 이전 글들과 동일한 방식(교차검증, 학습 세트에만 적용)으로 비교해봅시다.
from sklearn.model_selection import StratifiedKFold, cross_val_score
from sklearn.linear_model import LogisticRegression
from imblearn.over_sampling import SMOTE, BorderlineSMOTE, ADASYN
from imblearn.pipeline import Pipeline as ImbPipeline

X, y = make_classification(
    n_samples=3000, n_features=10, n_informative=5, n_redundant=2,
    weights=[0.95, 0.05], class_sep=1.0, random_state=RANDOM_STATE,
)
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=RANDOM_STATE)

baseline_scores = cross_val_score(
    LogisticRegression(max_iter=2000, random_state=RANDOM_STATE), X, y, cv=cv, scoring="f1"
)
print(f"[베이스라인, 샘플링 없음]  F1 평균: {baseline_scores.mean():.4f}")

for name, sampler in [
    ("SMOTE", SMOTE(random_state=RANDOM_STATE)),
    ("BorderlineSMOTE", BorderlineSMOTE(random_state=RANDOM_STATE)),
    ("ADASYN", ADASYN(random_state=RANDOM_STATE)),
]:
    pipeline = ImbPipeline([
        ("sampler", sampler),
        ("model", LogisticRegression(max_iter=2000, random_state=RANDOM_STATE)),
    ])
    scores = cross_val_score(pipeline, X, y, cv=cv, scoring="f1")
    print(f"[{name:16s}] F1 평균: {scores.mean():.4f}")
실제 실행 결과:
[베이스라인, 샘플링 없음]  F1 평균: 0.3403
[SMOTE           ] F1 평균: 0.2214
[BorderlineSMOTE ] F1 평균: 0.2149
[ADASYN          ] F1 평균: 0.1984
이번에도 이전 글들과 같은 패턴이 반복됩니다. 즉, SMOTE 계열 기법 모두 이 데이터셋에서는 베이스라인보다 F1이 낮게 나왔습니다. SMOTE가 무작위 복제보다 정교한 것은 사실이지만, "정교한 방법이므로 반드시 성능을 높여준다"는 보장은 어디에도 없습니다. 이 데이터는 클래스가 이미 어느 정도 선형적으로 분리 가능하도록 생성되었기 때문에, 소수 클래스 샘플을 추가로 만들어내는 것이 Logistic Regression의 결정경계를 개선하기보다는 오히려 기본 임곗값(0.5) 기준의 Precision-Recall 균형을 소수 클래스 쪽으로 지나치게 밀어붙인 것으로 해석할 수 있습니다.
이 결과가 주는 실무적 교훈은 명확합니다. "SMOTE를 썼으니 안심"이 아니라, 반드시 베이스라인 및 다른 대안(가중치 조정, 임곗값 최적화)과 비교해야 합니다. "합성 데이터가 실제로 새로운 정보를 만든다고 과장하지 않는다"는 바로 이런 상황을 가리킵니다. SMOTE가 만든 점은 기존 두 점 사이의 선형 보간일 뿐, 데이터의 실제 비선형 분포를 반영한 진짜 새로운 관측이 아닙니다.
흔한 실수
- 범주형 변수가 섞인 데이터에 일반 SMOTE를 그대로 적용하는 것. 반드시 SMOTENC 등 범주형을 고려한 변형을 사용해야 한다.
- 고차원 데이터에서 이웃 개수(k_neighbors)를 검토 없이 기본값으로만 사용하는 것. 차원이 높을수록 이웃의 의미가 흐려지므로 k 값과 특징 선택을 함께 검토해야 한다.
- SMOTE를 쓰면 무조건 성능이 좋아질 것이라 가정하고 검증을 생략하는 것. 이번 장의 실습처럼 오히려 성능이 떨어질 수 있다.
- 라벨 잡음이 의심되는 데이터에서 SMOTE를 바로 적용하는 것. 잡음이 있는 소수 클래스 샘플 주변에도 합성 샘플이 만들어져 잡음이 증폭될 수 있다.
한 걸음 더: Physical AI 시대의 합성 데이터 — SMOTE에서 World Model로
SMOTE는 "기존 샘플 사이를 선형으로 보간한다"는 비교적 단순한 가정 위에 서 있습니다. 그런데 최근 로보틱스와 자율주행 같은 Physical AI(물리 세계와 상호작용하는 AI) 분야에서는 훨씬 더 정교한 방식의 합성 데이터 생성이 표준으로 자리 잡고 있습니다. 여기에서 그 흐름을 소개하고, SMOTE와의 개념적 연결고리를 짚어봅니다.
World Foundation Model(세계 기반 모델, WFM)이란 무엇인가. World Model은 "다음에 어떤 이미지가 나올지"만 예측하는 일반 영상 생성 모델과 달리, 물체가 어떻게 움직이고 충돌하고 상호작용하는지에 대한 물리 법칙 자체를 데이터로부터 학습한 모델입니다. 엔비디아는 로봇과 인간으로부터 수집한 실제 및 합성 영상, 오디오, 행동 데이터를 포함한 대규모 멀티모달 데이터로 세계 기반 모델을 학습시켰습니다. 2025년 초 공개된 NVIDIA Cosmos에 이어, 2026년 6월에는 시각 추론과 세계 생성, 행동 예측을 하나의 시스템으로 결합한 개방형 모델인 Cosmos 3이 공개되었습니다.
SMOTE의 보간을 "가상의 상황 생성"으로 확장한 것. SMOTE가 기존 두 샘플 사이를 이어 새로운 특징 벡터 하나를 만들어냈다면, World Model 기반 합성 데이터 생성은 훨씬 더 큰 스케일에서 비슷한 역할을 합니다. Cosmos Transfer 계열 모델은 세그멘테이션 맵, 깊이 맵, 라이다 스캔, 자세 추정, 궤적 맵과 같은 구조화된 입력을 받아 사실적인 영상을 생성하며, 3D 시뮬레이션이나 기준 데이터를 대규모의 통제 가능한 합성 데이터로 변환합니다. 즉, "실제로 관측된 적은 없지만 물리적으로 있을 법한 장면"을 이미지 몇 장이 아니라 영상 시퀀스 전체로 만들어내는 것입니다. 이는 SMOTE가 표 형태 데이터의 한 점을 보간하던 것을, 시공간적으로 훨씬 복잡한 로봇·자율주행 데이터에 적용한 것에 가깝습니다.
희귀 사건(edge case)에 특히 유용한 이유. 자율주행에서 정말로 중요한 것은 사고 직전 상황, 갑작스러운 보행자 돌발, 극단적 기상 조건처럼 실제 주행 데이터에서는 극히 드물게만 등장하는 장면들입니다. 이 책의 문제의식과 정확히 같습니다. Waymo는 로보택시의 희귀 상황(edge case)을 시뮬레이션하기 위해 Genie 3를 활용한 Waymo World Model이라는 변형 모델을 만들었습니다. 이는 실제 사고 데이터를 억지로 더 모으는 대신, 학습된 세계 모델로 "있을 법한 위험 시나리오"를 대량으로 생성해 소수 클래스(위험 상황) 데이터를 보강하는 접근으로 볼 수 있습니다.
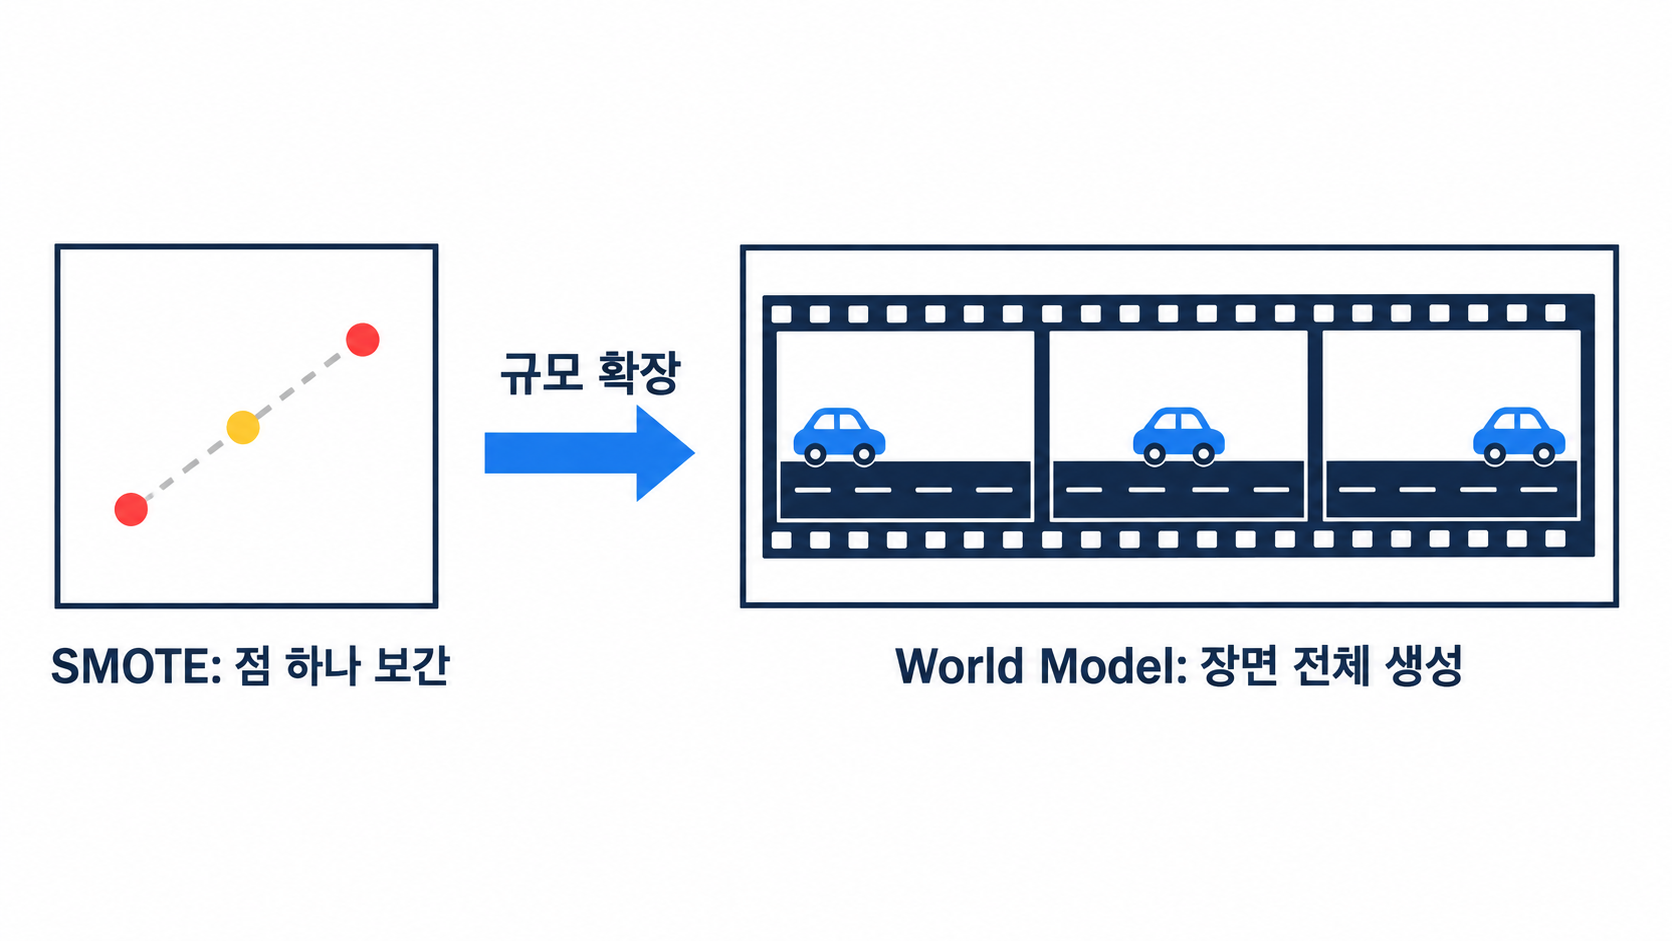
World Model 자체의 발전 속도. DeepMind의 Genie 3는 프롬프트 기반 입력만으로 실시간 상호작용이 가능한 3차원 환경을 생성하며, 화면 밖 요소에 대해서도 공간적 일관성을 유지하는 것이 특징입니다. 2026년 들어 World Model 패러다임은 급격히 주류로 부상했으며, NVIDIA Cosmos 플랫폼은 로보틱스와 자율주행 개발자들이 물리 법칙을 반영한 합성 학습 데이터를 적극적으로 채택하면서 누적 다운로드 수가 크게 늘었습니다.
그럼에도 과장해서는 안 되는 이유는 명확합니다. World Model이 생성한 영상이 아무리 사실적이라도, 이는 여전히 학습된 분포 안에서의 보간·외삽입니다. 실제 물리 법칙을 완벽히 재현하지 못하면 미묘하게 비현실적인 장면(sim-to-real gap)이 만들어질 수 있고, 이런 데이터로 학습한 모델은 실제 환경에서 예상치 못하게 실패할 수 있습니다. SMOTE가 만든 점이 "진짜 관측"이 아니듯, World Model이 만든 장면도 "진짜 세계"가 아니라 모델이 학습한 세계에 대한 근사라는 점을 항상 기억해야 합니다. 따라서 실무에서는 합성 데이터로 사전 학습(pre-training)이나 데이터 증강을 하더라도, 최종 검증은 반드시 실제 데이터로 수행해야 합니다.
참고 자료(집필 시점 최신 동향):
- NVIDIA Cosmos / Cosmos 3 공식 소개: nvidia.com/en-us/ai/cosmos/
- NVIDIA Cosmos 3 출시 보도자료(2026년 6월): investor.nvidia.com (NVIDIA Newsroom)
- DeepMind Genie 3 및 Waymo World Model 관련 보도: Wikipedia "Genie (world model)", TechCrunch(2025년 8월)
- World Model 산업 동향 정리: introl.com "World Models Race 2026"
더 알아보기: 텍스트 데이터에서의 생성형 합성 — LLM 기반 증강
지금까지 다룬 SMOTE와 World Model은 모두 수치형·영상 데이터를 다뤘습니다. 그런데 악성 리뷰 탐지, 혐오 발언 분류, 고객 문의 유형 분류처럼 텍스트 데이터에서도 소수 클래스 부족 문제는 매우 흔합니다. 이 경우 SMOTE의 "선형 보간"은 애초에 적용하기 어렵습니다. 텍스트는 연속적인 벡터가 아니라 이산적인 토큰들의 나열이라, 두 문장 임베딩 사이를 보간해도 그 결과가 항상 자연스러운 문장으로 복원되지는 않기 때문입니다.
대신 최근에는 대형 언어 모델(LLM)에게 "이런 유형의 소수 클래스 예시와 비슷하지만 표현이 다른 문장을 만들어 달라"고 요청하는 방식의 LLM 기반 텍스트 증강이 널리 쓰입니다. 예를 들어 실제 악성 리뷰 30건을 예시로 주고, 같은 패턴(공격적 어조, 특정 주제)을 공유하되 표현이 다른 새로운 예시를 LLM으로 생성해 학습 데이터에 추가하는 식입니다. 이는 개념적으로 SMOTE의 "그럴듯한 새 샘플 생성"을 텍스트 도메인으로 옮긴 것이지만, 보간이 아니라 생성 모델의 언어적 이해력에 기반한 패러프레이징이라는 점에서 원리가 다릅니다.
다만 이 접근에도 이번 글에서 배운 원칙이 그대로 적용됩니다. LLM이 생성한 문장이 실제 소수 클래스의 다양성을 얼마나 잘 대표하는지는 검증이 필요하며, 생성된 문장이 특정 패턴(예: 특정 단어 반복)에 치우치면 오히려 모델이 그 얕은 패턴만 암기하는 새로운 형태의 과적합이 발생할 수 있습니다. "합성 데이터가 실제로 새로운 정보를 만든다고 과장하지 않는다"는 원칙은 표 데이터든, 영상이든, 텍스트든 동일하게 적용됩니다.
더 알아보기: 이미지·표 데이터에서의 또 다른 합성 방법 — MixUp과 GAN 계열
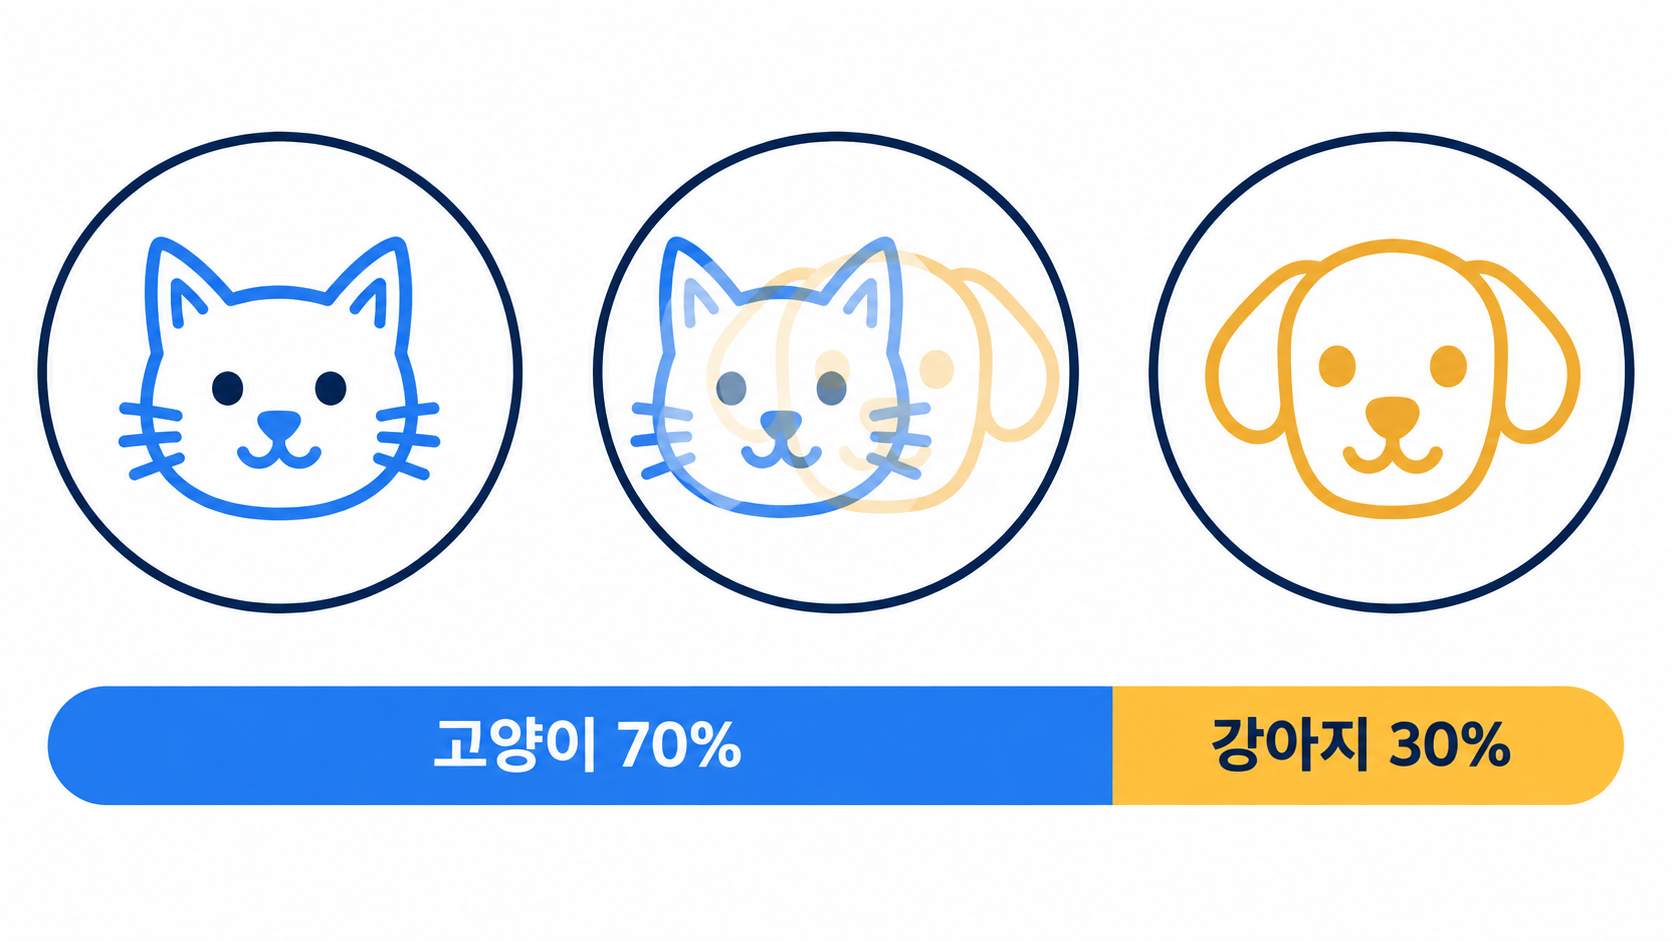
MixUp(이미지 분류): 컴퓨터 비전에서는 SMOTE의 "선형 보간"과 유사한 아이디어를 이미지에 직접 적용한 MixUp이 널리 쓰입니다. 두 이미지를 무작위 비율로 픽셀 단위로 섞고, 그 라벨도 같은 비율로 섞어 새로운 학습 샘플을 만드는 방식입니다. SMOTE가 특징 벡터를 보간한다면, MixUp은 이미지 자체와 라벨을 동시에 보간한다는 점에서 원리가 거의 동일합니다.
import numpy as np
import torch

def mixup_data(x, y_onehot, alpha=1.0):
    """두 이미지와 원-핫 라벨을 같은 비율로 섞어 새로운 학습 샘플을 만든다."""
    lam = np.random.beta(alpha, alpha) if alpha > 0 else 1.0
    index = torch.randperm(x.size(0))
    mixed_x = lam * x + (1 - lam) * x[index]
    mixed_y = lam * y_onehot + (1 - lam) * y_onehot[index]
    return mixed_x, mixed_y
GAN·VAE 기반 표 데이터 합성(CTGAN 등): 표 형태 데이터에서도 SMOTE의 선형 보간보다 정교한 대안으로, GAN(생성적 적대 신경망)을 표 데이터에 맞게 변형한 CTGAN, VAE 기반 합성기 등이 쓰입니다. ydata-synthetic 같은 라이브러리로 비교적 쉽게 시도해볼 수 있습니다. SMOTE가 "가까운 두 점 사이의 직선"만 그리는 반면, GAN 계열은 데이터 전체의 분포를 학습해 훨씬 다양한 형태의 합성 샘플을 생성할 수 있다는 장점이 있지만, 학습 자체가 불안정할 수 있고 소수 클래스처럼 샘플이 적은 상황에서는 GAN 학습에 필요한 데이터量 자체가 부족할 수 있다는 한계도 있습니다.
표로 정리한 다섯 가지 합성 데이터 접근
| SMOTE | MixUp | GAN·VAE(CTGAN 등) | World Model | LLM 텍스트 증강 | |
|---|---|---|---|---|---|
| 데이터 형태 | 수치형 특징 벡터 | 이미지 | 표 형태 데이터 전반 | 영상·행동 시퀀스 | 자연어 텍스트 |
| 생성 원리 | 선형 보간 | 이미지·라벨 동시 보간 | 학습된 데이터 분포에서 샘플링 | 학습된 물리 법칙 기반 생성 | 언어 모델의 패러프레이징·생성 |
| 주요 활용 분야 | 정형 데이터 분류 | 이미지 분류 | 정형 데이터(SMOTE의 대안) | 로보틱스, 자율주행 | 텍스트 분류 |
| 핵심 위험 | 잡음 증폭, 차원의 저주 | 라벨이 애매한 혼합 이미지 생성 가능 | 학습 불안정, 데이터 부족 시 품질 저하 | Sim-to-real gap | 얕은 패턴 암기로 인한 새로운 과적합 |
| 공통점 | 다섯 기법 모두 "실제로 관측되지 않았지만 그럴듯한 사례"를 만들어 희귀 클래스/상황을 보강한다는 근본 목적을 공유한다 |
더 알아보기: 오버샘플링 배율(ratio)도 하이퍼파라미터다
지금까지는 SMOTE를 적용할 때 "소수 클래스를 다수 클래스와 1:1이 될 때까지 늘린다"는 기본값을 그대로 사용했습니다. 하지만 얼마나 늘릴 것인가(배율)도 검증을 통해 정해야 하는 하이퍼파라미터입니다. 실제로 다수 클래스 대비 2배, 5배, 10배로 늘렸을 때 결과가 모델마다 다르게 나타납니다.
# 설치가 필요한 환경에서 한 번만 실행
# !pip install -q scikit-learn imbalanced-learn numpy

import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import StratifiedKFold, cross_val_score
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
from imblearn.over_sampling import SMOTE
from imblearn.pipeline import Pipeline as ImbPipeline

RANDOM_STATE = 42
X, y = make_classification(
    n_samples=4000, n_features=10, n_informative=5, n_redundant=2,
    weights=[0.95, 0.05], class_sep=1.0, random_state=RANDOM_STATE,
)
n_minority = np.sum(y == 1)
n_majority = np.sum(y == 0)
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=RANDOM_STATE)

def make_ratio_sampler(multiplier):
    """소수 클래스를 원래 개수의 multiplier배까지 늘리는 SMOTE 샘플러."""
    target = min(int(n_minority * multiplier), n_majority)
    return SMOTE(random_state=RANDOM_STATE, sampling_strategy={1: target})

for model_name, model in [
    ("LogisticRegression", LogisticRegression(max_iter=2000, random_state=RANDOM_STATE)),
    ("RandomForest", RandomForestClassifier(n_estimators=200, random_state=RANDOM_STATE)),
]:
    baseline = cross_val_score(model, X, y, cv=cv, scoring="average_precision")
    print(f"[{model_name}] 베이스라인 PR-AUC: {baseline.mean():.4f}")
    for mult in [2, 5, 10]:
        pipeline = ImbPipeline([("sampler", make_ratio_sampler(mult)), ("model", model)])
        scores = cross_val_score(pipeline, X, y, cv=cv, scoring="average_precision")
        print(f"[{model_name}] SMOTE {mult}배        PR-AUC: {scores.mean():.4f}")
실행 결과:
[LogisticRegression] 베이스라인 PR-AUC: 0.4517
[LogisticRegression] SMOTE 2배        PR-AUC: 0.4450
[LogisticRegression] SMOTE 5배        PR-AUC: 0.4378
[LogisticRegression] SMOTE 10배       PR-AUC: 0.4302

[RandomForest] 베이스라인 PR-AUC: 0.7308
[RandomForest] SMOTE 2배        PR-AUC: 0.7326
[RandomForest] SMOTE 5배        PR-AUC: 0.7336
[RandomForest] SMOTE 10배       PR-AUC: 0.7103
Logistic Regression은 배율을 높일수록 PR-AUC가 꾸준히 낮아지는 반면, Random Forest는 2~5배까지는 베이스라인보다 미세하게 개선되다가 10배에서는 오히려 크게 떨어집니다. 즉 "어느 모델에는 이 정도 배율이 적당하다"는 규칙은 데이터마다 다시 확인해야 하며, 배율 자체를 나중에 배울 GridSearchCV 탐색 대상에 포함시키는 것이 안전합니다. 실무에서 보고된 사례(예: 대형 신용카드 사기 데이터셋 벤치마크)에서는 앙상블 모델이 공격적인 배율(10배 이상)에서도 이득을 보는 경우가 많았지만, 이 역시 데이터에 따라 달라지므로 일반화해서는 안 됩니다.
더 알아보기: 합성 데이터가 그럴듯한지 UMAP으로 확인하기
SMOTE가 만든 합성 샘플이 실제 소수 클래스 패턴과 비슷한 위치에 있는지, 아니면 이상한 곳에 흩어져 있는지 눈으로 확인하고 싶을 때가 있습니다. 특징이 10개 이상이면 직접 산점도로 그릴 수 없으므로, UMAP(고차원 데이터를 2차원으로 압축하면서 데이터의 지역적·전역적 구조를 최대한 보존하는 차원 축소 기법)을 활용할 수 있습니다.
# 설치가 필요한 환경에서 한 번만 실행
# !pip install -q umap-learn scikit-learn imbalanced-learn numpy matplotlib

import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from imblearn.over_sampling import SMOTE
import umap

RANDOM_STATE = 42
X, y = make_classification(
    n_samples=2000, n_features=10, n_informative=5, n_redundant=2,
    weights=[0.95, 0.05], class_sep=1.0, random_state=RANDOM_STATE,
)

# SMOTE로 합성 샘플만 따로 추출 (원본 소수 클래스 이후에 추가된 부분)
smote = SMOTE(random_state=RANDOM_STATE)
X_resampled, y_resampled = smote.fit_resample(X, y)
n_original_minority = np.sum(y == 1)
X_synthetic = X_resampled[y_resampled == 1][n_original_minority:]

# UMAP은 반드시 원본(실제) 데이터로만 학습시킨 뒤, 합성 샘플을 같은 좌표계로 투영한다
reducer = umap.UMAP(random_state=RANDOM_STATE, n_neighbors=15, min_dist=0.1)
embedding_real = reducer.fit_transform(X)
embedding_synthetic = reducer.transform(X_synthetic)

plt.figure(figsize=(7, 6))
plt.scatter(embedding_real[y == 0, 0], embedding_real[y == 0, 1],
            s=8, alpha=0.3, label="다수 클래스(실제)")
plt.scatter(embedding_real[y == 1, 0], embedding_real[y == 1, 1],
            s=20, alpha=0.8, color="red", label="소수 클래스(실제)")
plt.scatter(embedding_synthetic[:, 0], embedding_synthetic[:, 1],
            s=10, alpha=0.5, color="orange", label="SMOTE 합성 샘플")
plt.legend()
plt.title("UMAP으로 확인한 SMOTE 합성 샘플의 위치")
plt.savefig("smote_umap_check.png", dpi=150)
print("UMAP 시각화를 smote_umap_check.png로 저장했습니다.")
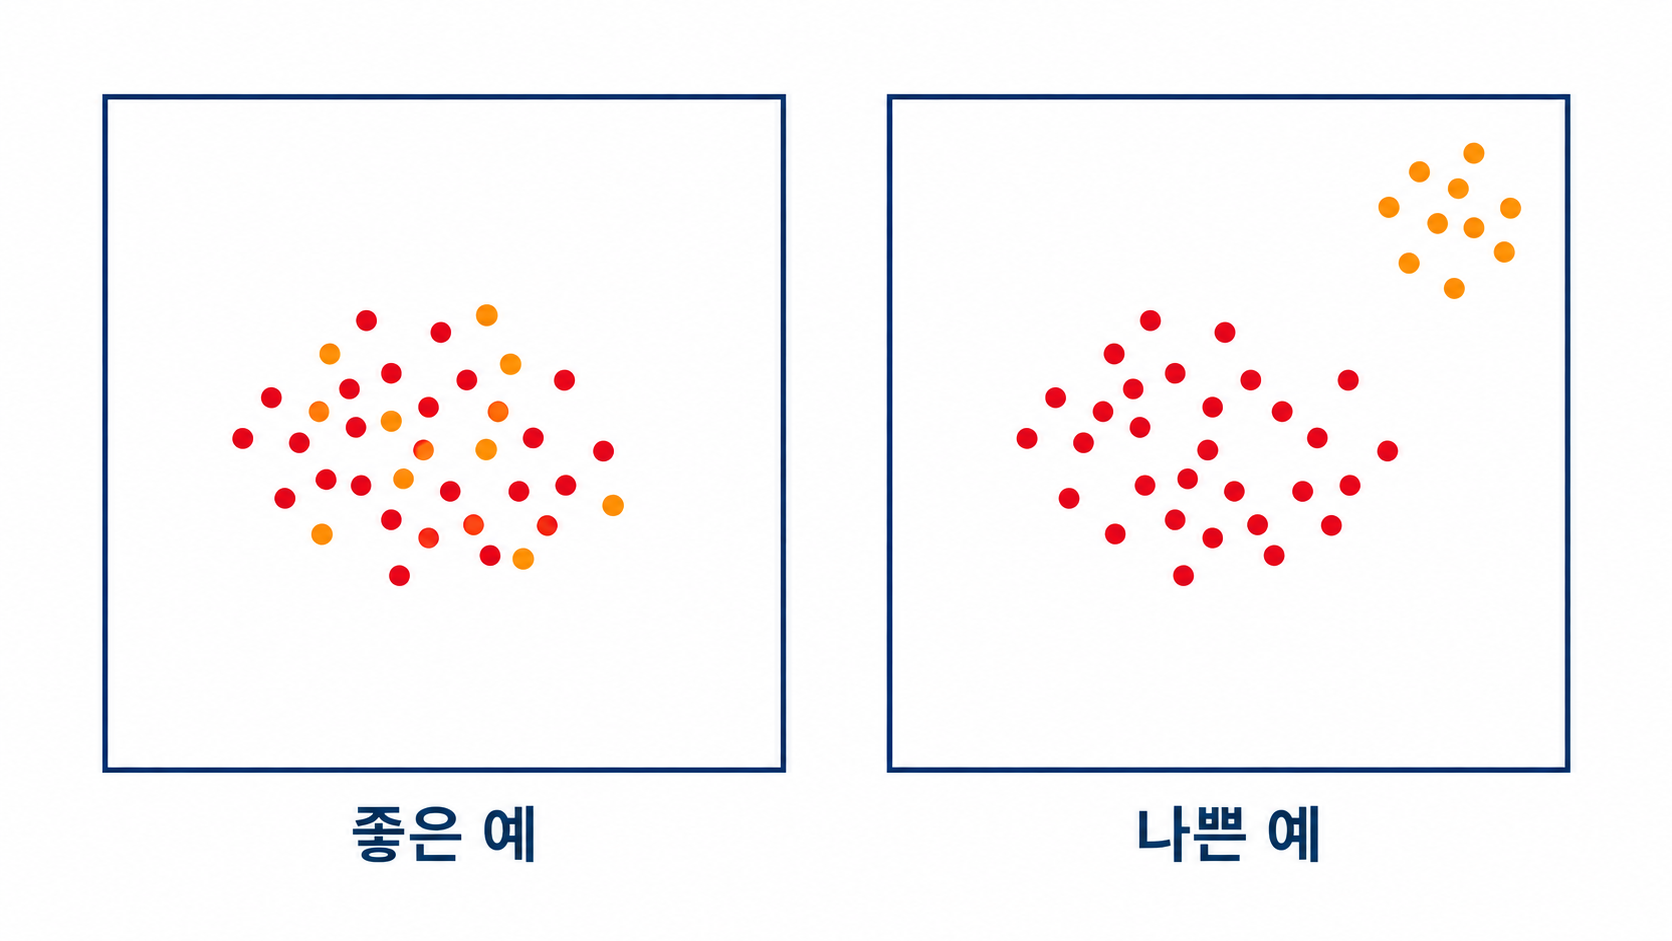
합성 샘플(주황색)이 실제 소수 클래스(빨간색) 주변에 겹치거나 인접해서 나타난다면 SMOTE가 그럴듯한 샘플을 만들고 있다는 신호입니다. 반대로 합성 샘플이 다수 클래스 영역 한가운데 흩어지거나, 실제 데이터 어디에도 속하지 않는 고립된 "섬"을 형성한다면, 그 SMOTE 설정(이웃 개수, 배율 등)을 재검토해야 한다는 경고 신호로 해석해야 합니다. 이 시각적 점검은 이 글 전체에서 강조한 "합성 데이터를 과신하지 않는다"는 원칙을, 코드 한 번으로 실제로 확인해보는 절차입니다.
'머신러닝' 카테고리의 다른 글
| 불균형 데이터 다루기 12 - 클래스 가중치와 비용 민감 학습 (0) | 2026.09.13 |
|---|---|
| 불균형 데이터 다루기 11 - 잡음과 경계를 다듬는 하이브리드 샘플링 (0) | 2026.09.13 |
| 불균형 데이터 다루기 9 - 소수 데이터를 늘리는 오버샘플링 (0) | 2026.09.12 |
| 불균형 데이터 다루기 8 - 다수 데이터를 줄이는 언더샘플링 (0) | 2026.09.12 |
| 불균형 데이터 다루기 7 - 분할·교차검증·데이터 누수 방지 (0) | 2026.09.12 |