"데이터 자체는 건드리지 않고, 모델에게 '소수 클래스를 틀리면 더 아프다'고 가르칠 수 있을까?" 이전 글들에서는 데이터를 직접 조작하는 샘플링 기법을 다뤘습니다. 이번 글부터는 데이터는 그대로 두고, 알고리즘의 학습 방식 자체를 바꾸는 접근을 다룹니다. 그 첫걸음이 클래스 가중치와 비용 민감 학습입니다.
배점이 다른 시험 문제
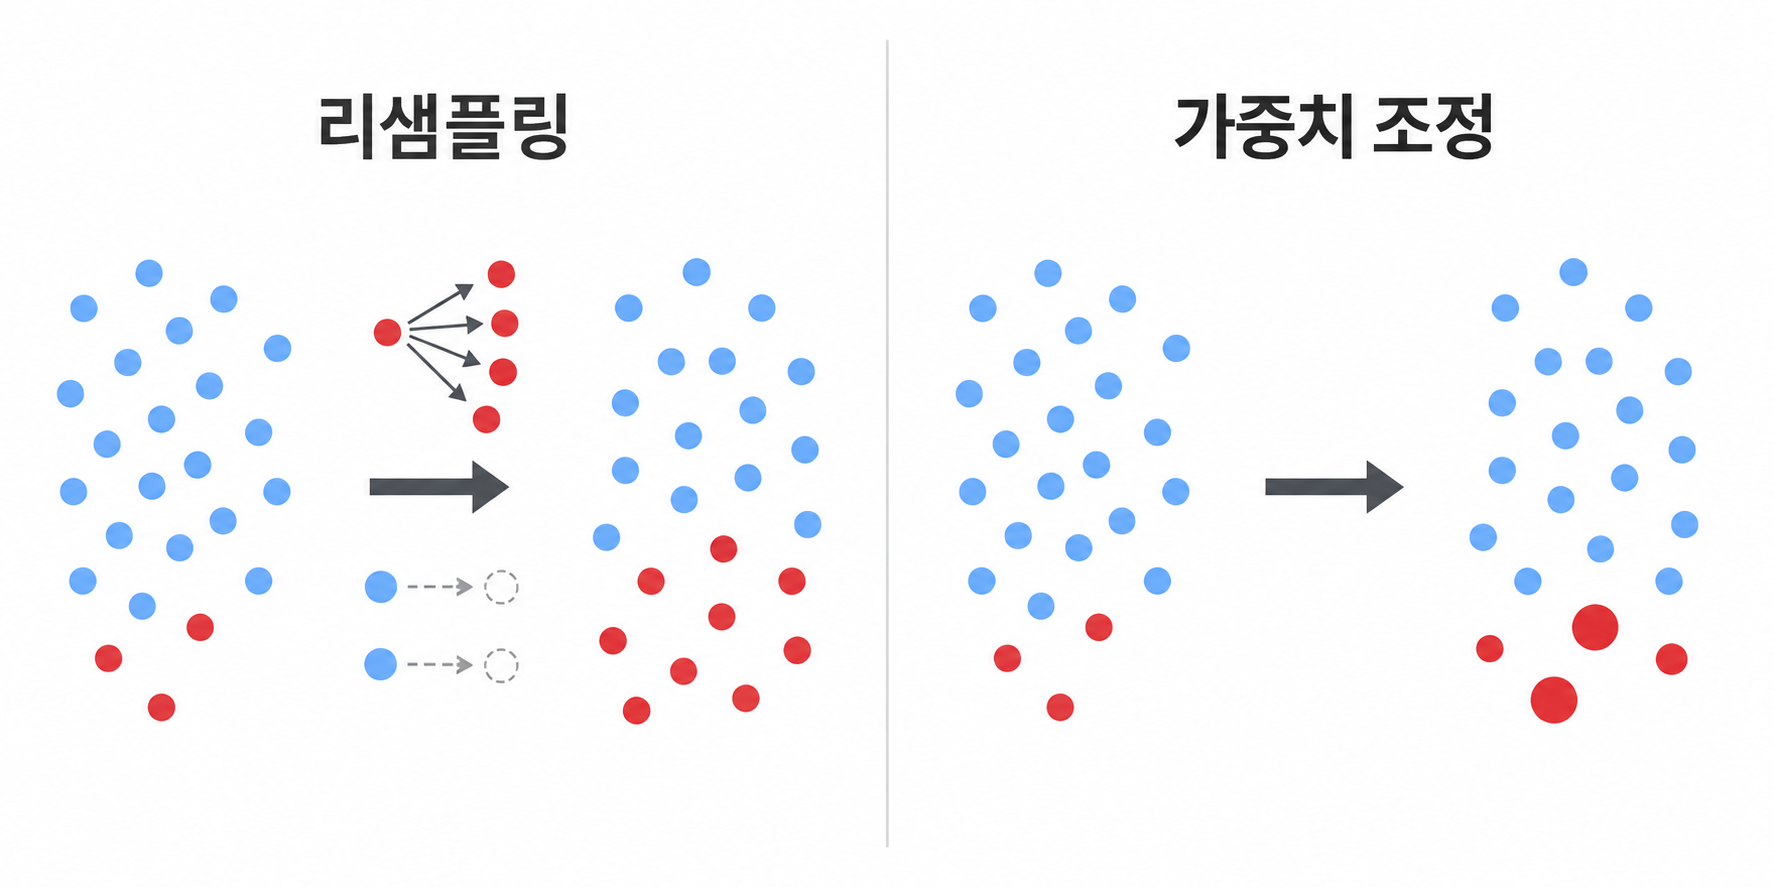
어떤 시험에 문제가 100개 있는데, 그중 95개는 배점이 1점이고 5개는 배점이 20점이라고 해봅시다. 학생이 배점 1점짜리 문제를 다 맞히고 20점짜리 문제를 다 틀려도 점수는 95점입니다. 하지만 만약 20점짜리 문제들이 "가장 중요한 개념"을 묻는 문제라면, 이 채점 방식은 뭔가 잘못되었습니다. 배점을 재조정해서 20점짜리 문제 5개에 각각 훨씬 높은 가중치를 준다면, 학생(모델)은 자연스럽게 그 문제들에 더 신경을 쓰게 됩니다. 클래스 가중치는 정확히 이런 방식으로 손실함수의 "배점"을 소수 클래스 쪽으로 옮기는 방법입니다.
손실함수에서 클래스별 오류에 다른 무게를 주는 원리
일반적인 분류 모델의 학습은 전체 데이터에 대한 손실(오류)의 합을 최소화하는 방향으로 이루어집니다. 클래스 가중치를 적용하면, 특정 클래스의 샘플에서 발생한 손실에 곱해지는 계수를 다르게 설정합니다.
전체 손실 = Σ w_yi × loss(y_i, 예측값_i)
여기서 w_yi는 샘플 i가 속한 클래스의 가중치입니다. 소수 클래스의 가중치를 크게 설정하면, 그 클래스를 잘못 맞혔을 때의 손실이 더 크게 반영되어 모델이 그 클래스를 더 신경 써서 학습하게 됩니다.
class_weight='balanced'의 계산 방식
scikit-learn의 class_weight='balanced' 옵션은 다음 공식으로 가중치를 자동 계산합니다.
w_클래스 = 전체 샘플 수 / (클래스 개수 × 해당 클래스 샘플 수)
예를 들어 다수 클래스 2,850개, 소수 클래스 150개(전체 3,000개, 클래스 2개)라면:
w_다수 = 3000 / (2 × 2850) ≈ 0.526
w_소수 = 3000 / (2 × 150) = 10.0
소수 클래스 하나를 틀렸을 때의 손실이 다수 클래스 하나를 틀렸을 때보다 약 19배(10.0 / 0.526) 더 크게 반영됩니다.
sample_weight와 사용자 정의 비용 행렬
class_weight가 "클래스 단위"로 가중치를 준다면, sample_weight는 개별 샘플 단위로 가중치를 부여할 수 있어 더 세밀한 조정이 가능합니다. 예를 들어 사기 금액이 클수록 더 높은 가중치를 주는 식입니다. 더 나아가 앞에서 다룬 비용 행렬(어떤 오류가 얼마나 비싼가)을 직접 클래스 가중치로 변환해 사용할 수도 있습니다. 예를 들어 거짓 음성(사기를 놓침)의 비용이 거짓 양성(정상 거래를 의심)의 10배라면, 소수 클래스 가중치를 다수 클래스 가중치의 10배로 설정하는 식입니다.
Resampling과 Weighting의 장단점 비교
| 리샘플링 | 클래스 가중치 | |
|---|---|---|
| 데이터 자체 | 변형됨(추가 또는 제거) | 원본 그대로 유지 |
| 계산 비용 | 샘플 수 변화에 따라 증가/감소 | 거의 변화 없음 |
| 정보 손실/왜곡 위험 | 있음(언더샘플링: 손실, 오버샘플링: 중복) | 상대적으로 적음 |
| 모델 지원 범위 | 대부분의 모델에 적용 가능 | 가중치를 지원하는 모델(대부분의 scikit-learn 모델)에서만 직접 사용 가능 |
| 파이프라인 복잡도 | Pipeline으로 누수 방지 필요(7장) | 학습 시 파라미터로 전달, 누수 위험이 상대적으로 낮음 |
| 대표 상황 | 샘플링 자체가 유의미한 데이터 정제 효과를 줄 때 | 데이터를 원본 그대로 보존하고 싶을 때, 계산 자원이 제한적일 때 |

작은 숫자 예제
다수 클래스 2,850개, 소수 클래스 150개인 데이터에서 class_weight='balanced'를 적용하면:
- w_다수 = 3000 / (2 × 2850) ≈ 0.5263
- w_소수 = 3000 / (2 × 150) = 10.0
만약 어떤 배치에서 다수 클래스를 3개, 소수 클래스를 2개 틀렸다면:
- 가중치 없는 손실 기여: 3 + 2 = 5
- 가중치 적용 손실 기여: (3 × 0.5263) + (2 × 10.0) = 1.579 + 20.0 = 21.58
소수 클래스의 오류 2건이 전체 손실에서 차지하는 비중이 가중치 적용 전(40%)보다 적용 후(약 93%)에 압도적으로 커진 것을 확인할 수 있습니다. 모델은 이 손실을 줄이기 위해 소수 클래스를 더 정확히 맞히는 방향으로 학습됩니다.
Python 실습: Logistic Regression과 SVM의 가중치별 성능 변화
# 설치가 필요한 환경에서 한 번만 실행
# !pip install -q scikit-learn numpy

import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import StratifiedKFold, cross_val_score
from sklearn.linear_model import LogisticRegression
from sklearn.svm import SVC
from sklearn.utils.class_weight import compute_class_weight

RANDOM_STATE = 42
np.random.seed(RANDOM_STATE)

X, y = make_classification(
    n_samples=3000,
    n_features=10,
    n_informative=5,
    n_redundant=2,
    weights=[0.95, 0.05],
    class_sep=1.0,
    random_state=RANDOM_STATE,
)

# balanced 옵션이 실제로 계산하는 가중치 값 확인
weights = compute_class_weight(class_weight="balanced", classes=np.array([0, 1]), y=y)
print(f"class_weight='balanced' 계산 결과: 다수 클래스={weights[0]:.4f}, 소수 클래스={weights[1]:.4f}")
print("-" * 60)

cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=RANDOM_STATE)

print("[Logistic Regression]")
for cw in [None, "balanced"]:
    scores = cross_val_score(
        LogisticRegression(max_iter=2000, random_state=RANDOM_STATE, class_weight=cw),
        X, y, cv=cv, scoring="f1",
    )
    label = "가중치 없음" if cw is None else "class_weight='balanced'"
    print(f"  {label:28s} F1 평균: {scores.mean():.4f}")

print("\n[SVM]")
for cw in [None, "balanced"]:
    scores = cross_val_score(
        SVC(class_weight=cw, random_state=RANDOM_STATE),
        X, y, cv=cv, scoring="f1",
    )
    label = "가중치 없음" if cw is None else "class_weight='balanced'"
    print(f"  {label:28s} F1 평균: {scores.mean():.4f}")
실제 실행 결과:
class_weight='balanced' 계산 결과: 다수 클래스=0.5291, 소수 클래스=9.0909

------------------------------------------------------------
[Logistic Regression]
  가중치 없음                   F1 평균: 0.3403
  class_weight='balanced'      F1 평균: 0.2226

[SVM]
  가중치 없음                   F1 평균: 0.4532
  class_weight='balanced'      F1 평균: 0.4363
Logistic Regression과 SVM 모두, class_weight='balanced'를 적용했을 때 F1이 오히려 소폭 낮아졌습니다. 이전 글들의 샘플링 기법들과 정확히 같은 패턴입니다. 이는 우연이 아닙니다. class_weight='balanced'는 사실상 오버샘플링과 매우 비슷한 효과를 냅니다. 손실함수 관점에서 소수 클래스 가중치를 10배 늘리는 것은, 대략적으로 소수 클래스 샘플을 10배 복제해서 학습시키는 것과 비슷한 방향으로 결정경계를 이동시킵니다. 따라서 앞에서 확인한 "복제가 항상 도움이 되는 것은 아니다"라는 교훈이 여기서도 그대로 적용됩니다.
다만 SVM에서는 그 하락 폭이 매우 작습니다(0.4532 → 0.4363). 이는 SVM의 결정경계가 서포트 벡터(경계 근처의 소수 샘플들)에 의해 결정되는 방식이 Logistic Regression과 다르기 때문입니다. 어떤 모델에 어떤 기법이 더 잘 맞는지는 모델의 특성에 따라 달라지므로, 이 역시 실험으로 확인해야 합니다.
흔한 실수
- 리샘플링과 클래스 가중치를 동시에 강하게 적용해 이중 보정하는 것. 예를 들어 SMOTE로 이미 1:1 비율을 맞춘 데이터에
class_weight='balanced'까지 적용하면, 이미 균형 잡힌 데이터에 불필요한 추가 가중치가 들어가 오히려 소수 클래스 쪽으로 과도하게 치우칠 수 있다. class_weight='balanced'가 항상 F1을 높여줄 것이라 기대하는 것. 이번 실습처럼 오히려 낮아질 수 있으므로 베이스라인과 비교해야 한다.- 가중치를 조정하면 Precision과 Recall 사이의 트레이드오프 자체가 사라진다고 착각하는 것. 가중치는 트레이드오프의 위치를 옮길 뿐, 트레이드오프 자체를 없애지는 못한다.
한 걸음 더: Resampling과 Weighting, 언제 어느 쪽을 선택할까
이론적으로 class_weight='balanced'와 오버샘플링은 밀접하게 연관되어 있지만, 실무적으로는 다음 기준으로 선택하는 것이 합리적입니다.
- 데이터 규모가 매우 크고 계산 자원이 제한적이라면 → 클래스 가중치(데이터 복제 없이 동일한 효과를 계산 비용 증가 없이 얻을 수 있음)
- 모델이 가중치 파라미터를 지원하지 않는다면(일부 커스텀 모델, 특정 딥러닝 구조) → 리샘플링
- 원본 데이터의 통계적 성질(평균, 분산 등)을 보존해야 하는 후속 분석이 있다면 → 클래스 가중치(데이터 자체를 바꾸지 않으므로)
- 소수 클래스 내부의 다양한 패턴을 더 풍부하게 만들고 싶다면 → SMOTE 계열 샘플링(단순 가중치는 새로운 정보를 추가하지 않음)
가장 중요한 원칙은 이번 글과 앞에서 반복해서 확인했듯, 어떤 선택도 검증 없이 "당연히 더 낫다"고 가정해서는 안 된다는 것입니다.
'머신러닝' 카테고리의 다른 글
| 불균형 데이터 다루기 14 - 딥러닝의 가중 손실과 Focal Loss (1) | 2026.09.14 |
|---|---|
| 불균형 데이터 다루기 13 - 트리 앙상블과 불균형 데이터 (0) | 2026.09.14 |
| 불균형 데이터 다루기 11 - 잡음과 경계를 다듬는 하이브리드 샘플링 (0) | 2026.09.13 |
| 불균형 데이터 다루기 10 - SMOTE와 합성 샘플링의 원리 (0) | 2026.09.13 |
| 불균형 데이터 다루기 9 - 소수 데이터를 늘리는 오버샘플링 (0) | 2026.09.12 |