"SMOTE(Synthetic Minority Over-sampling Technique) 같은 합성 샘플링을 전체 데이터에 먼저 적용한 뒤 학습/테스트로 나누면 왜 안 될까? 그리고 그렇게 하면 얼마나 위험한 착각에 빠지게 될까?"
이번 글은 이후 모든 실습의 기반이 되는 안전한 검증 틀을 만드는 부분 입니다. 여기서 다지는 원칙이 흔들리면, 뒤에서 아무리 좋은 샘플링·가중치 기법을 배워도 결과를 신뢰할 수 없습니다.
모의고사 문제를 공부 자료에 미리 섞어 넣기
시험 점수를 잘 받는 가장 확실하지만 부정한 방법은, 실제 시험 문제를 미리 알고 공부하는 것입니다. 이렇게 얻은 점수는 진짜 실력이 아니라 "정답을 미리 봤다"는 사실을 반영할 뿐입니다. 머신러닝에서도 똑같은 일이 벌어질 수 있습니다. 만약 SMOTE로 소수 클래스의 합성 샘플을 만든 뒤에 데이터를 학습/테스트로 나눈다면, 원본 샘플 A로부터 만들어진 합성 샘플이 학습 세트에, 그 A 자신은 테스트 세트에 들어갈 수 있습니다. 모델은 사실상 "정답이 살짝 변형된 문제"를 미리 공부한 셈이 되고, 테스트 점수는 실제 배포 환경에서의 성능을 심각하게 과대평가하게 됩니다. 이것이 데이터 누수(data leakage)입니다.
계층적 분할(Stratified Split)
불균형 데이터를 무작위로 나누면, 운이 나쁠 경우 테스트 세트에 소수 클래스가 거의 남지 않을 수 있습니다. Stratified split은 학습/테스트 세트 각각에서 클래스 비율을 원본과 동일하게 유지하도록 분할하는 방법입니다. scikit-learn의 train_test_split(..., stratify=y)나 StratifiedKFold가 이를 구현합니다.
왜 계층화만으로는 부족할 수 있는가?
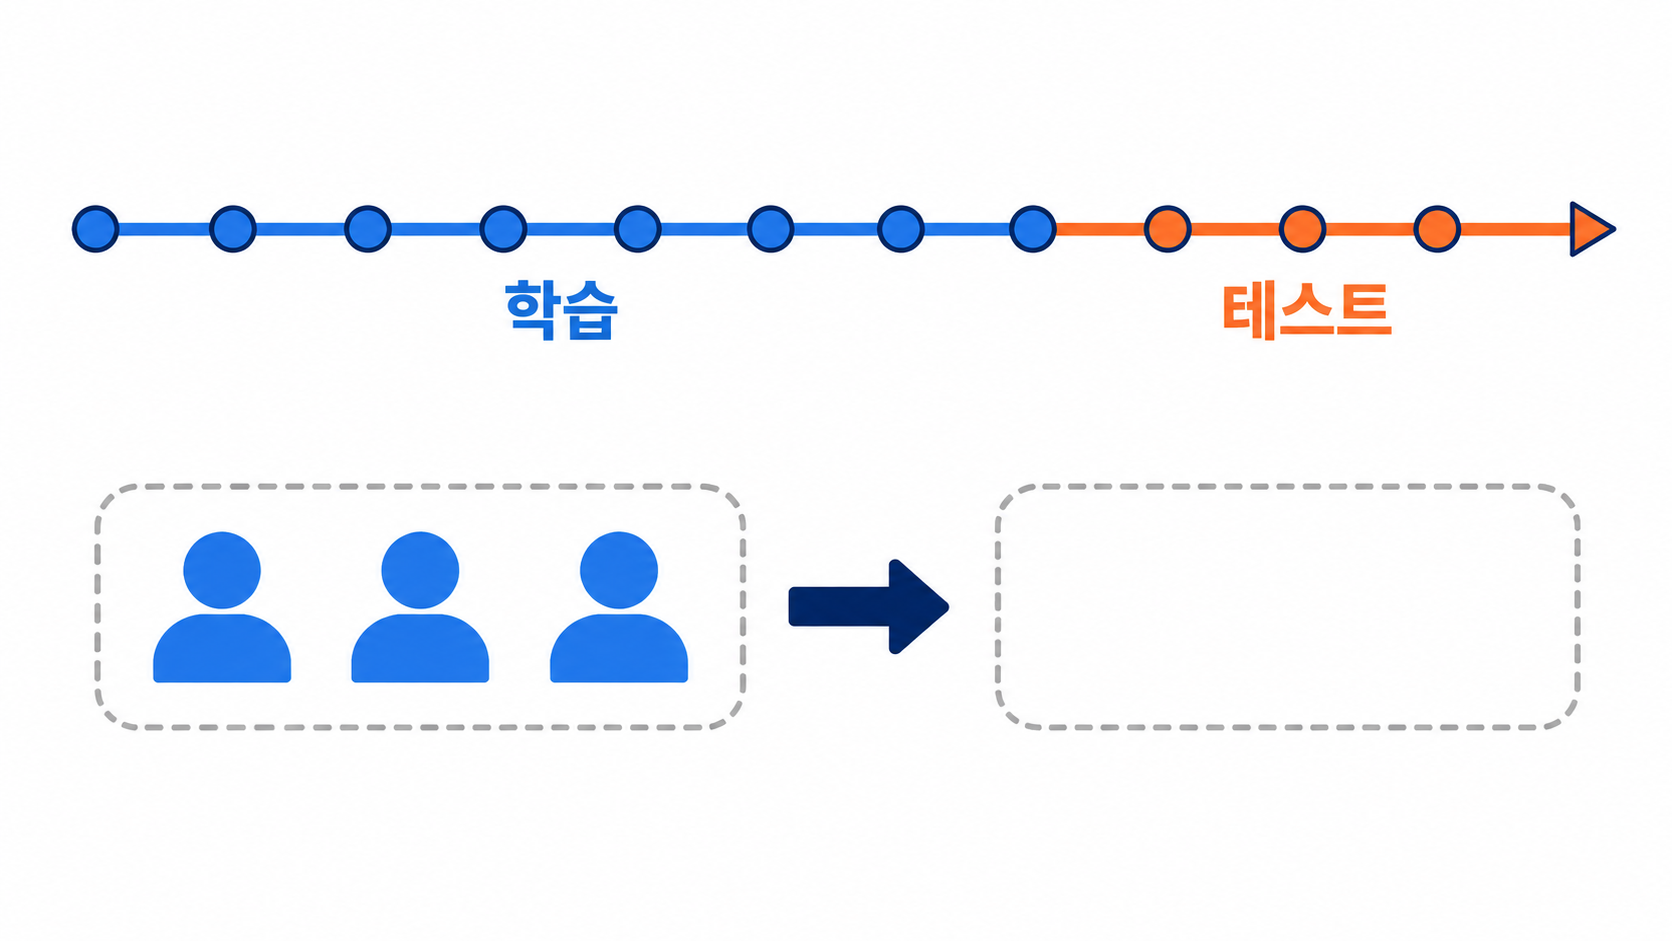
- 시간 데이터: 사기 탐지, 이탈 예측처럼 시간 순서가 있는 데이터에서 무작위(또는 계층적) 분할을 하면, 미래 데이터가 학습 세트에 섞여 들어가 "미래를 보고 과거를 예측하는" 비현실적인 상황이 생깁니다. 이 경우 시간 기준 분할(time-based split)을 사용해야 합니다. 즉, 특정 시점 이전 데이터로 학습하고 이후 데이터로 테스트합니다.
- 그룹 데이터: 같은 고객, 같은 환자, 같은 기기에서 나온 여러 행이 존재하는 경우, 같은 그룹의 데이터가 학습과 테스트에 나뉘어 들어가면 모델이 "그 고객의 다른 기록"을 몰래 참고하는 셈이 됩니다. 이때는 GroupKFold처럼 그룹 단위로 통째로 학습/테스트에 배정해야 합니다.
원칙적으로는 "데이터가 어떻게 생성되었는가"를 먼저 파악한 뒤, 그 생성 구조를 검증 방식에도 그대로 반영해야 합니다. 계층화는 기본값일 뿐, 항상 충분한 것은 아닙니다.
SMOTE와 데이터 누수
나중에 자세히 다룰 SMOTE는 기존 소수 클래스 샘플들 사이를 보간하여 새로운 가상 샘플을 만듭니다. 문제는 이 보간 과정을 언제 수행하느냐입니다.
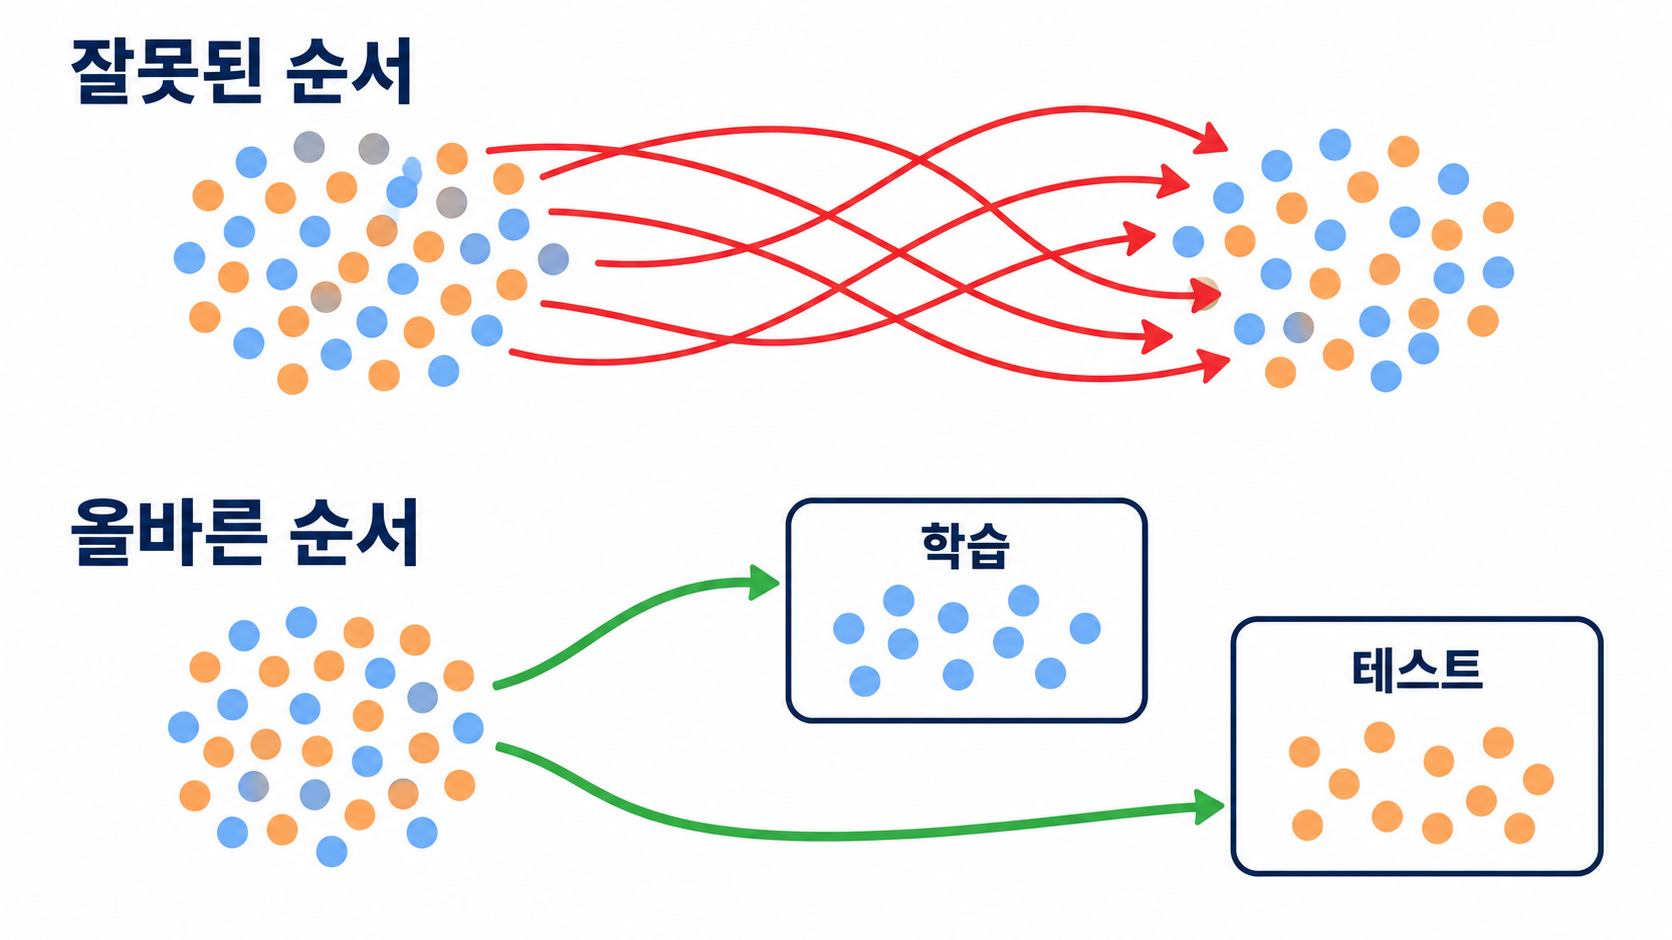
잘못된 순서 (누수 발생):
전체 데이터 → SMOTE 적용 (전체에서 합성 샘플 생성) → 학습/테스트 분할
이 순서에서는 원본 샘플과 그로부터 파생된 합성 샘플이 서로 다른 세트에 나뉘어 들어갈 수 있습니다. 원본과 합성 샘플은 매우 유사하므로, 모델은 테스트 세트의 샘플과 "거의 동일한" 샘플을 이미 학습 세트에서 본 뒤 평가받는 셈이 됩니다.
올바른 순서 (누수 없음):
전체 데이터 → 학습/테스트 분할 → 학습 세트에만 SMOTE 적용 → 학습 → 원본 테스트 세트로 평가
이 원칙은 교차검증에서도 동일하게 적용되어야 합니다. 즉, 각 fold마다 그 fold의 학습 부분에만 샘플링을 적용해야 하며, 이를 수동으로 반복하는 대신 imblearn.pipeline.Pipeline을 사용하면 자동으로 안전하게 처리됩니다.
작은 숫자 예제
소수 클래스가 20개뿐인 데이터가 있다고 합시다.
- 잘못된 방식: 전체 데이터(정상 980 + 소수 20)에 SMOTE를 적용해 소수 클래스를 200개로 늘린 뒤, 무작위로 80:20 분할. 이 경우 원본 소수 샘플 A와, A에서 파생된 합성 샘플 A'가 각각 학습/테스트에 나뉘어 들어갈 확률이 상당히 높습니다.
- 올바른 방식: 먼저 원본 데이터(정상 980 + 소수 20)를 80:20으로 분할(계층화 적용) → 학습 세트(정상 784 + 소수 16)에만 SMOTE 적용 → 테스트 세트(정상 196 + 소수 4)는 원본 그대로 유지.
두 방식의 테스트 점수를 비교하면, 잘못된 방식은 실제보다 훨씬 낙관적인 Precision/Recall을 보여주는 경향이 있습니다. 이는 실제 운영 환경에서 절대 재현되지 않는 "가짜 성능"입니다.
Python 실습: 잘못된 방식과 Pipeline 방식 비교
# 설치가 필요한 환경에서 한 번만 실행
# !pip install -q scikit-learn imbalanced-learn numpy

import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split, StratifiedKFold, cross_val_score
from sklearn.linear_model import LogisticRegression
from imblearn.over_sampling import SMOTE
from imblearn.pipeline import Pipeline as ImbPipeline

RANDOM_STATE = 42
np.random.seed(RANDOM_STATE)

# 1. 불균형 데이터 생성
X, y = make_classification(
    n_samples=2000,
    n_features=15,
    n_informative=6,
    n_redundant=3,
    weights=[0.97, 0.03],
    random_state=RANDOM_STATE,
)

# ============================================================
# [잘못된 방식] 전체 데이터에 먼저 SMOTE 적용 후 분할
# ============================================================
smote_full = SMOTE(random_state=RANDOM_STATE)
X_resampled_full, y_resampled_full = smote_full.fit_resample(X, y)

X_train_wrong, X_test_wrong, y_train_wrong, y_test_wrong = train_test_split(
    X_resampled_full, y_resampled_full,
    test_size=0.2,
    stratify=y_resampled_full,
    random_state=RANDOM_STATE,
)

model_wrong = LogisticRegression(max_iter=2000, random_state=RANDOM_STATE)
model_wrong.fit(X_train_wrong, y_train_wrong)
wrong_score = model_wrong.score(X_test_wrong, y_test_wrong)

print(f"[잘못된 방식] 테스트 정확도: {wrong_score:.4f}  (누수로 인해 과대평가된 값)")

# ============================================================
# [올바른 방식] 먼저 분할 후, 학습 세트에만 SMOTE 적용 (Pipeline 사용)
# ============================================================
X_train, X_test, y_train, y_test = train_test_split(
    X, y,
    test_size=0.2,
    stratify=y,
    random_state=RANDOM_STATE,
)

pipeline = ImbPipeline([
    ("smote", SMOTE(random_state=RANDOM_STATE)),
    ("model", LogisticRegression(max_iter=2000, random_state=RANDOM_STATE)),
])
pipeline.fit(X_train, y_train)
correct_score = pipeline.score(X_test, y_test)

print(f"[올바른 방식] 테스트 정확도  : {correct_score:.4f}  (누수 없는 신뢰 가능한 값)")

# ============================================================
# 교차검증에서도 동일한 원칙 적용: Pipeline을 cross_val_score에 통째로 전달
# ============================================================
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=RANDOM_STATE)
cv_scores = cross_val_score(pipeline, X_train, y_train, cv=cv, scoring="f1")

print(f"\n5-fold 교차검증 F1 점수: {np.round(cv_scores, 4)}")
print(f"평균 F1: {cv_scores.mean():.4f} (표준편차: {cv_scores.std():.4f})")
핵심 포인트: cross_val_score(pipeline, ...)처럼 Pipeline 객체 전체를 교차검증에 넘기면, scikit-learn이 각 fold마다 자동으로 "그 fold의 학습 부분에만 SMOTE를 적용 → 학습 → 그 fold의 검증 부분(원본 그대로)으로 평가"를 반복해줍니다. 이것이 데이터 누수를 원천적으로 방지하는 가장 안전한 방법입니다.
일반적으로 [잘못된 방식]의 테스트 정확도(또는 Precision/Recall)가 [올바른 방식]보다 눈에 띄게 높게 나오는 경향을 보입니다. 이 차이는 모델이 "더 잘 학습해서"가 아니라, 테스트 세트 자체가 이미 오염되어 실제보다 쉬운 문제가 되었기 때문입니다. 실무에서 이런 식으로 산출된 성능 지표를 그대로 보고하면, 실제 배포 후 성능이 보고서 수치에 크게 못 미치는 사고로 이어질 수 있습니다.
흔한 실수
- 샘플링을 교차검증 루프 바깥에서 한 번만 적용하는 것. "SMOTE 적용 → cross_val_score(model, ...)" 순서는 여전히 누수입니다. 반드시 Pipeline으로 감싸야 합니다.
- 테스트 세트에도 샘플링을 적용하는 것. 테스트 세트는 실제 운영 환경의 클래스 분포를 그대로 반영해야 하며, 어떤 형태로든 재샘플링하면 안 됩니다.
- 시간 순서가 있는 데이터에 무작정 stratified k-fold를 쓰는 것. 시계열적 성격이 있다면 TimeSeriesSplit 등 시간을 고려한 분할 방법을 사용해야 합니다.
- 그룹 구조를 무시하는 것. 같은 사용자·환자의 여러 레코드가 학습과 테스트에 흩어지면, 모델이 "그 사람의 다른 기록"으로부터 답을 유추할 수 있습니다.
한 걸음 더: 전처리 전체에 적용되는 원칙
이번 글의 원칙은 SMOTE뿐 아니라 학습 데이터로부터 통계량을 추정하는 모든 전처리에 동일하게 적용됩니다. 예를 들어 표준화(StandardScaler)의 평균·표준편차, 결측치 대체값, 특징 선택 기준 등도 전부 학습 fold 안에서만 계산되어야 합니다. "샘플링만 조심하면 된다"고 생각하기 쉽지만, 데이터 누수는 파이프라인의 어느 단계에서든 발생할 수 있는 일반적인 문제라는 점을 기억해야 합니다. 뒤 이 원칙을 GridSearchCV까지 확장한 완전한 실험 설계를 다룹니다.
'머신러닝' 카테고리의 다른 글
| 불균형 데이터 다루기 9 - 소수 데이터를 늘리는 오버샘플링 (0) | 2026.09.12 |
|---|---|
| 불균형 데이터 다루기 8 - 다수 데이터를 줄이는 언더샘플링 (0) | 2026.09.12 |
| 불균형 데이터 다루기 6 - 업무 비용과 목표에 맞는 평가 기준 (0) | 2026.09.12 |
| 불균형 데이터 다루기 5 - ROC 곡선과 PR 곡선을 제대로 읽는 법 (0) | 2026.09.11 |
| 불균형 데이터 다루기 4 - 혼동행렬에서 시작하는 분류 지표 (1) | 2026.09.11 |