코딩테스트에서 정답을 맞히는 것과 "통과"를 받는 것은 다른 이야기예요. 논리적으로는 맞는 코드인데도 시간초과로 떨어지는 경험, 다들 한 번쯤 해보셨을 거예요. 이번 글에서는 알고리즘이 무엇인지부터 시작해서, "이 코드가 얼마나 걸릴지 가늠하는" 복잡도 감각을 몸에 익혀볼게요. 이 감각 하나만 있어도 코드를 짜기 전에 "이 방법은 되겠다/안 되겠다"를 미리 알 수 있게 됩니다.
1. 알고리즘이란 무엇인가? — 그리고 시간복잡도란 무엇인가?
시간초과, 그 억울한 빨간 글씨
분명히 정답 로직대로 짰는데 채점 결과에 초록색 "맞았습니다" 대신 빨간색 "시간 초과"가 뜬 적 있으신가요? 코드는 논리적으로 틀리지 않았는데도 떨어지는 이 상황이, 사실 알고리즘 문제 풀이에서 가장 자주 마주치는 벽이에요. 정답을 내는 방법은 여러 가지가 있는데, 그중에는 "느린 정답"과 "빠른 정답"이 있고, 코딩테스트는 그 차이를 냉정하게 채점합니다. 이번 글에서는 그 차이를 가르는 두 가지 개념, 알고리즘과 시간복잡도를 첫걸음으로 이해해볼게요.
핵심 개념
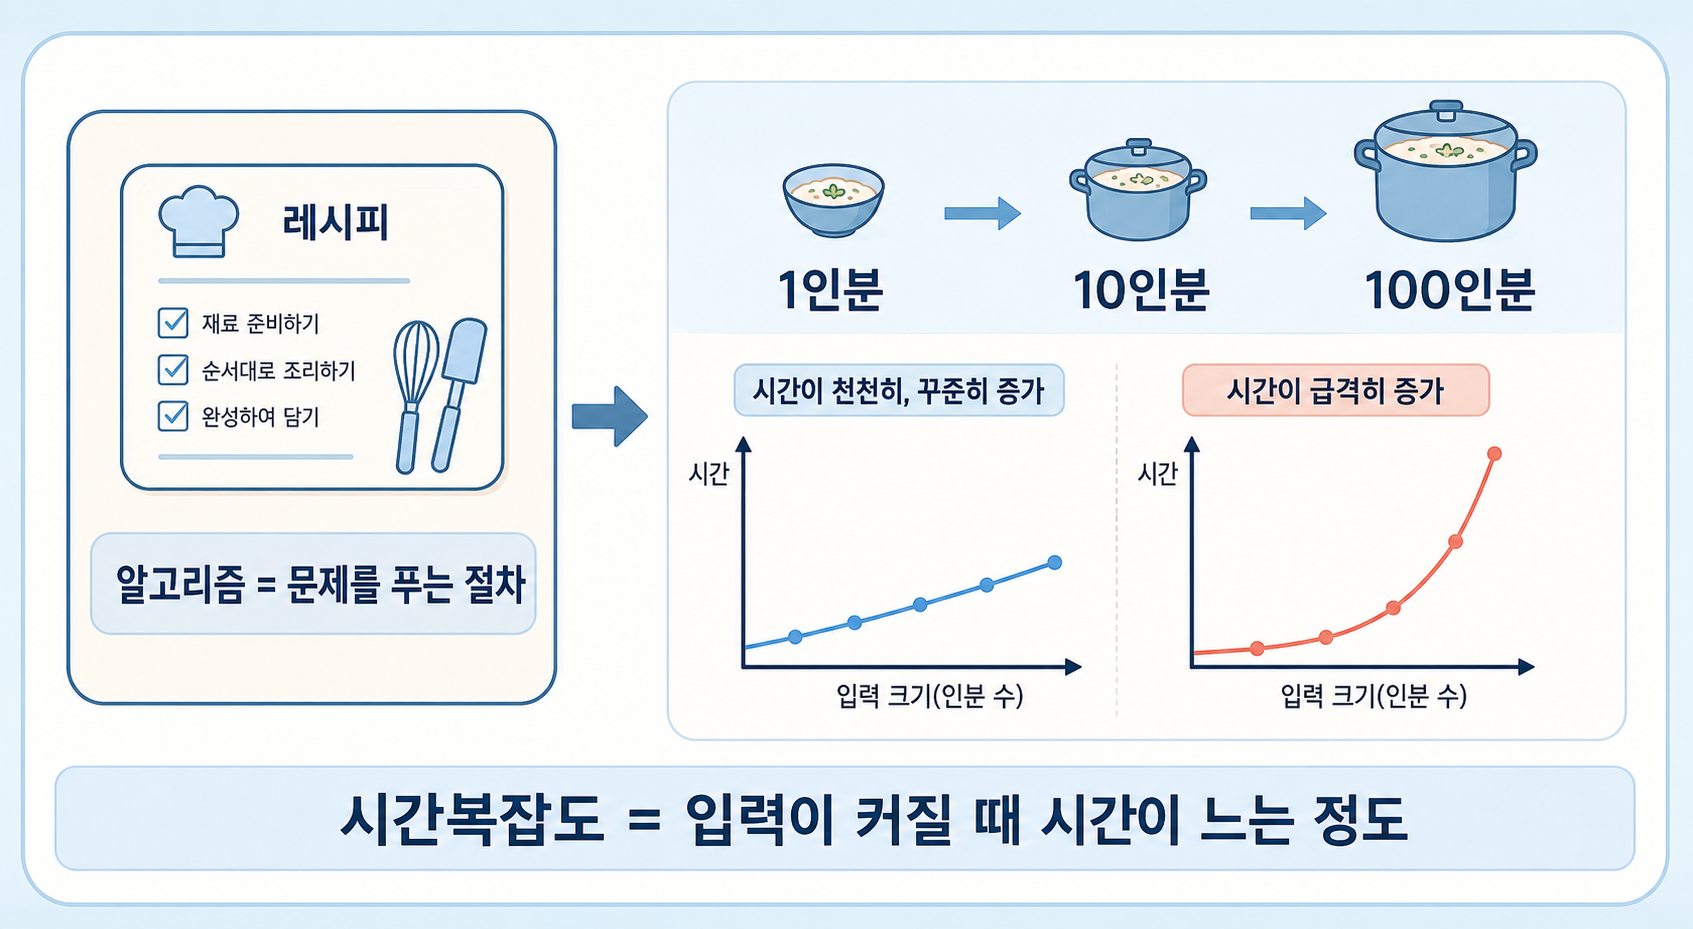
알고리즘이란 "어떤 문제를 풀기 위해 정해진 순서대로 실행하는 절차"이고, 시간복잡도란 "입력의 크기가 커질수록 그 절차의 실행 시간이 얼마나 빠르게 늘어나는가"를 재는 잣대예요.
비유로 이해하기
알고리즘은 요리 레시피와 같아요. "물을 끓인다 → 면을 넣는다 → 4분 기다린다 → 건진다"처럼 순서가 정해진 절차를 그대로 따라 하면 누가 만들어도 라면이 완성되죠. 그런데 같은 라면을 끓이는 레시피라도, 재료 손질에 5분 걸리는 레시피와 30분 걸리는 레시피가 있을 수 있어요. 이때 "재료가 몇 인분이냐에 따라 손질 시간이 얼마나 늘어나는가"를 따지는 게 바로 시간복잡도예요. 예를 들어 도서관에서 책 한 권을 찾을 때, 서가 첫 칸부터 한 권씩 다 훑어보는 방법과, 분류 팻말(목차)을 보고 구역을 절반씩 좁혀가는 방법은 걸리는 시간이 완전히 다르죠 — 이 "절반씩 좁혀가기"의 정체는 다른 글에 이분 탐색으로 제대로 다룰 예정이니, 지금은 "같은 목적지라도 가는 길에 따라 시간이 크게 달라질 수 있다"는 감각만 가져가시면 됩니다.
수식으로 표현하기
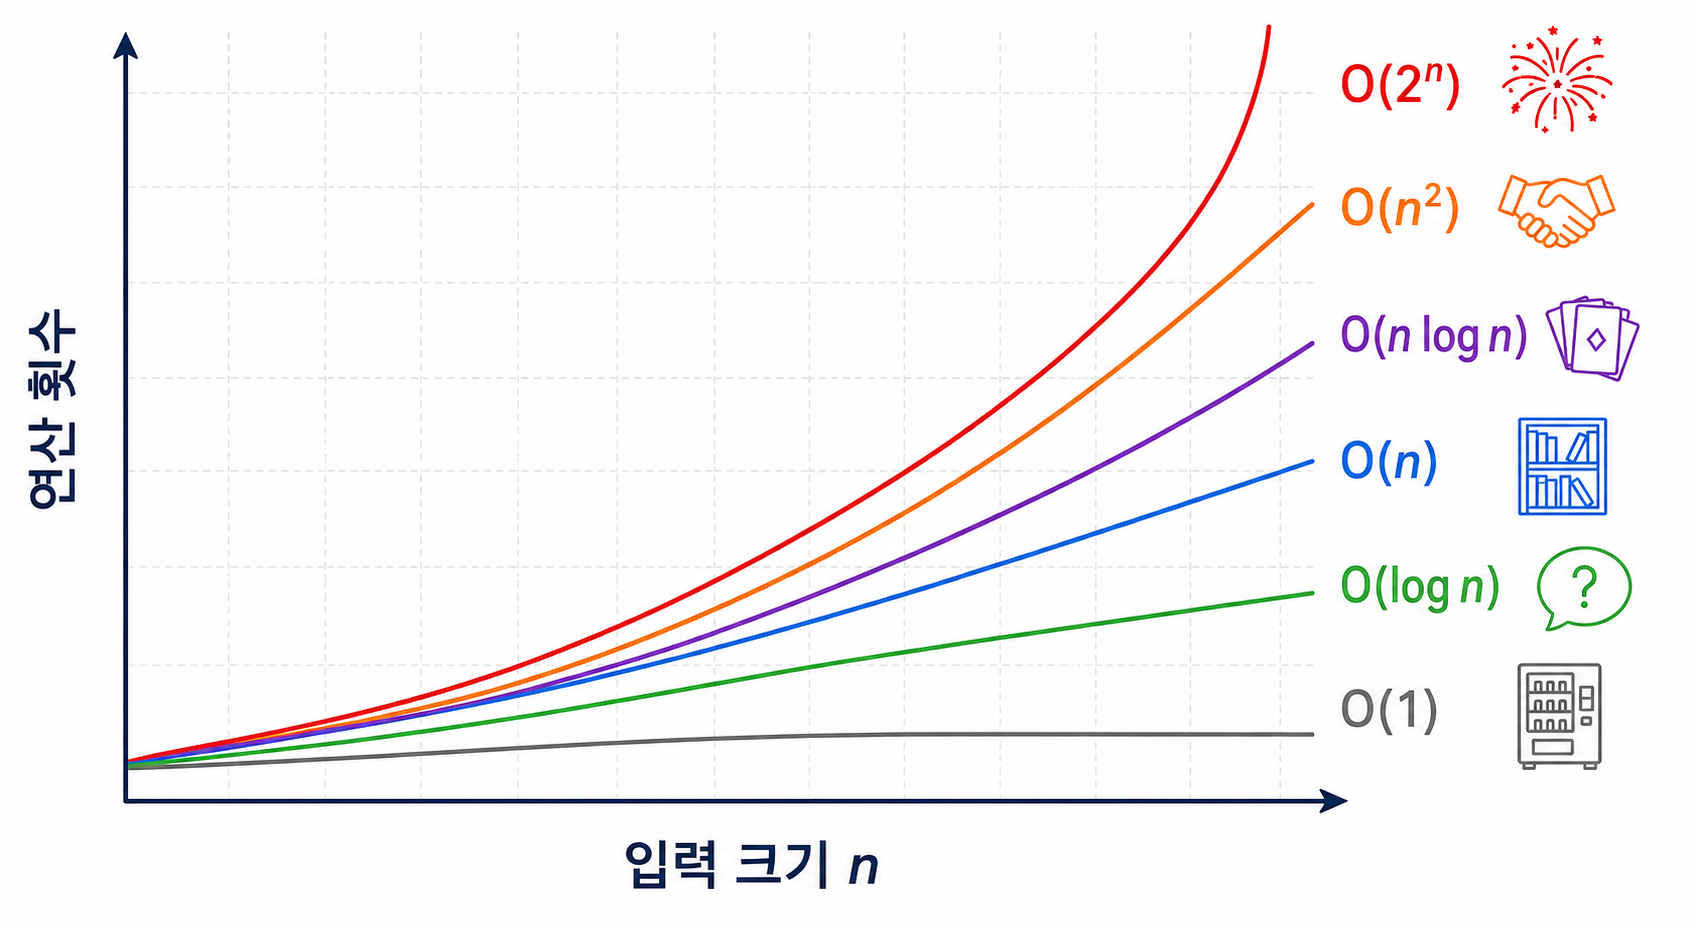
시간복잡도는 보통 연산 횟수가 입력 크기 n에 대해 어떤 함수 꼴로 늘어나는지로 표현해요. 대표적으로 n에 비례하는 O(n), n의 제곱에 비례하는 O(n²), 2의 n제곱으로 폭발하는 O(2ⁿ) 같은 것들이 있죠. n이 커질수록 이 셋의 격차가 얼마나 벌어지는지 표로 보면 감이 확 옵니다.
n (입력 크기)O(n) 연산 횟수O(n²) 연산 횟수O(2ⁿ) 연산 횟수
| 10 | 10 | 100 | 1,024 |
| 100 | 100 | 10,000 | 약 1.27 × 10³⁰ |
| 1,000 | 1,000 | 1,000,000 | 사실상 계산 불가능한 천문학적 숫자 |
n이 10일 때는 셋 다 그럭저럭 감당할 만하지만, n이 1,000만 되어도 O(2ⁿ)은 이미 우주의 나이(약 138억 년)보다 긴 시간이 걸릴 만큼 폭발해버려요. 이게 바로 "느린 정답"이 코딩테스트에서 떨어지는 이유입니다.
Colab 코드로 확인하기
# 알고리즘이란 무엇인가 — 시간복잡도: O(1) (표 출력 자체는 입력 크기와 무관하게 고정된 3개 값만 계산)
def operation_counts(n):
    """입력 크기 n일 때 O(n), O(n^2), O(2^n) 각각의 대략적인 연산 횟수를 계산합니다."""
    linear = n
    quadratic = n ** 2
    exponential = 2 ** n  # n이 커지면 이 값이 순식간에 어마어마해집니다
    return linear, quadratic, exponential

# 입력 예시: n = 10, 100, 1000일 때 비교
for n in [10, 100, 1000]:
    linear, quadratic, exponential = operation_counts(n)
    # n=1000일 때 2**n은 자릿수가 300자리가 넘는 숫자라 그대로 출력하면 너무 기니, 자릿수만 보여줍니다
    exp_display = exponential if n <= 100 else f"{len(str(exponential))}자리 숫자"
    print(f"n={n:5d} | O(n)={linear:10,d} | O(n^2)={quadratic:15,d} | O(2^n)={exp_display}")

# 출력 예시:
# n=   10 | O(n)=        10 | O(n^2)=            100 | O(2^n)=1024
# n=  100 | O(n)=       100 | O(n^2)=         10,000 | O(2^n)=1267650600228229401496703205376
# n= 1000 | O(n)=     1,000 | O(n^2)=      1,000,000 | O(2^n)=302자리 숫자
코드 설명: operation_counts 함수는 같은 n에 대해 세 가지 복잡도가 실제로 몇 번의 연산을 요구하는지를 그대로 계산해서 보여줘요. 2 ** n 부분이 핵심인데, n이 딱 1000만 되어도 결과가 300자리가 넘는 숫자가 되어버리는 걸 직접 눈으로 확인할 수 있습니다.
틀리기 쉬운 포인트
⚠️ "알고리즘이 맞다 = 통과한다"라고 착각하기 쉬워요. 논리적으로 정답을 내는 코드라도 시간복잡도가 너무 크면 시간초과로 틀린 답 취급을 받습니다.
# 틀리기 쉬운 생각: "정답만 나오면 되겠지"
def find_pair_sum(nums, target):  # O(n^2) — n이 10만이면 100억 번 연산, 시간초과 위험
    for i in range(len(nums)):
        for j in range(i + 1, len(nums)):
            if nums[i] + nums[j] == target:
                return True
    return False
정답 로직 자체는 맞지만, 입력 크기가 큰 문제에서는 "얼마나 걸리는가"까지 미리 따져봐야 합니다.
코딩테스트에 연결하기
백준이나 프로그래머스 문제 설명 맨 아래에는 항상 "시간 제한: 1초", "N ≤ 100,000" 같은 조건이 붙어 있어요. 이 숫자들이 바로 "당신의 알고리즘은 어느 정도 복잡도여야 통과한다"는 힌트예요. 예를 들어 백준 2557 Hello World처럼 입력 크기 자체가 없는 문제는 복잡도를 걱정할 필요가 없지만, 백준 2739 구구단처럼 반복문을 쓰는 순간부터 "이 반복문이 몇 번 도는가"가 곧 시간복잡도가 됩니다. 앞으로 이 글에서 다룰 모든 문제는 결국 "이 절차(알고리즘)를 어떻게 짜야 시간 제한 안에 들어올까"라는 질문으로 귀결돼요.
한 줄로 정리하면
알고리즘은 문제를 푸는 절차이고, 시간복잡도는 그 절차가 입력이 커질수록 얼마나 느려지는지를 재는 잣대입니다.
더 알아보기
사실 실행 시간은 컴퓨터 성능, 프로그래밍 언어, 심지어 그날의 서버 상태에 따라서도 조금씩 달라져요. 그래서 시간복잡도는 "정확히 몇 초"가 아니라 "입력이 2배가 되면 시간이 몇 배가 되는가"라는 증가 패턴(성장률)에 주목합니다. 이 성장률을 표현하는 공식 표기법이 바로 다음에 배울 빅오(Big-O)예요.
직접 풀어보기 (연습문제)
- [난이도: 초급] 백준 2557 Hello World — 알고리즘도 결국 "순서대로 실행되는 절차"라는 걸 가장 단순한 코드로 체감해보세요.
- [난이도: 중급] 백준 2739 구구단 — 반복문이 몇 번 도는지 손으로 세어보면서 "반복 횟수 = 시간복잡도의 실마리"임을 느껴보세요.
- * 이 글에서는 저작권 문제가 될 수 있기 때문에 연습문제를 직접 기술하지 않습니다만, 구글에서 "백준 2557"나 "백준 2739"로 검색해 보시면 다양한 풀이 방법이 나오니 그 내용을 참고하시기 바랍니다.
2. 빅오(Big-O) 표기법 감 잡기 — O(1)부터 O(2ⁿ)까지 그림으로 비교
"이 풀이는 O(n log n)입니다"라는 한마디
알고리즘 강의나 정답 풀이 게시판을 보면 "이 방법은 O(n)이라 빠르고, 저 방법은 O(n²)이라 느립니다" 같은 문장을 자주 보게 돼요. 처음 보면 이 알파벳과 괄호가 대체 뭘 뜻하는지 막막하죠. 사실 빅오는 어렵게 생각할 것 없이, "입력이 커질 때 시간이 어떤 모양으로 늘어나는가"를 한눈에 알아보는 일종의 등급 표시예요. 이번 글에서 대표적인 빅오들을 실생활 비유와 함께 쭉 훑어볼게요.
핵심 개념
빅오 표기법(Big-O)이란 알고리즘의 실행 시간이 입력 크기 n에 대해 최악의 경우 얼마나 빠르게 늘어나는지를, 자잘한 상수나 낮은 차수는 무시하고 가장 지배적인 항만 남겨서 표현하는 방법이에요.
비유로 이해하기
O(1)은 입력이 몇 개든 상관없이 즉시 끝나는 "자판기 버튼 누르기"예요 — 음료가 10개든 100개든 원하는 버튼 하나만 누르면 끝나죠. O(log n)은 "1부터 1000까지 숫자 맞히기 게임"이에요, 매번 반씩 걸러내니 몇 번 안에 끝나요. O(n)은 "책장의 책을 처음부터 끝까지 한 권씩 확인하기"고, O(n log n)은 "카드 여러 벌을 효율적으로 정렬하기"처럼 n번보다는 많지만 n²번보다는 훨씬 적게 걸리는 중간 지대예요. O(n²)은 "학급 학생 전원이 서로 한 번씩 악수하기"처럼 모든 쌍을 다 따져야 하는 경우고, O(2ⁿ)은 "가방에 넣을 물건들의 모든 조합을 다 시도해보기"처럼 물건 하나가 늘 때마다 경우의 수가 두 배로 폭발하는 상황이에요.
수식으로 표현하기
빅오는 "가장 크게 기여하는 항만 남기고 나머지는 버린다"는 원칙을 따라요. 예를 들어 어떤 알고리즘의 실제 연산 횟수가 3n² + 5n + 7이라면, n이 아주 커질 때는 3n² 항이 압도적으로 커지므로 상수 3과 나머지 항을 다 무시하고 그냥 O(n²)이라고 씁니다. 마찬가지로 10n + 100은 O(n), n log n + n은 O(n log n)이 돼요. 즉 빅오는 "정확한 초 단위 시간"이 아니라 "n이 커질 때 어떤 모양의 곡선을 그리는가"를 나타내는 표기법입니다.
Colab 코드로 확인하기
# 빅오 감 잡기 — 시간복잡도: 이 코드 자체는 O(n) 크기와 O(n^2) 크기를 각각 실제로 실행해서 시간을 재는 실험 코드입니다
import time

def linear_work(n):
    # O(n): 리스트를 한 번만 훑습니다
    total = 0
    for i in range(n):
        total += i
    return total

def quadratic_work(n):
    # O(n^2): 이중 반복문으로 모든 쌍을 훑습니다
    total = 0
    for i in range(n):
        for j in range(n):
            total += 1
    return total

# 입력 크기를 두 배씩 늘려가며 실행 시간을 측정합니다
for n in [1000, 2000, 4000]:
    start = time.perf_counter()
    linear_work(n)
    linear_time = time.perf_counter() - start

    start = time.perf_counter()
    quadratic_work(n)
    quadratic_time = time.perf_counter() - start

    print(f"n={n:5d} | O(n) 시간: {linear_time:.5f}초 | O(n^2) 시간: {quadratic_time:.5f}초")

# 출력 예시(환경마다 수치는 다를 수 있음):
# n= 1000 | O(n) 시간: 0.00006초 | O(n^2) 시간: 0.05812초
# n= 2000 | O(n) 시간: 0.00012초 | O(n^2) 시간: 0.23481초
# n= 4000 | O(n) 시간: 0.00024초 | O(n^2) 시간: 0.94103초
코드 설명: n이 2배가 될 때 linear_work의 시간은 거의 2배로만 늘어나지만, quadratic_work의 시간은 약 4배(2²배)로 늘어나는 걸 직접 확인할 수 있어요. 이렇게 "입력이 몇 배 될 때 시간이 몇 배가 되는가"를 재보는 것이 빅오를 몸으로 이해하는 가장 확실한 방법입니다.
틀리기 쉬운 포인트
⚠️ "반복문이 두 개면 무조건 O(n²)"라고 성급하게 판단하는 경우가 많아요. 중첩된 반복문이라도 안쪽 반복문의 범위가 고정된 상수라면 여전히 O(n)일 수 있습니다.
# 겉보기엔 이중 반복문이지만 실제로는 O(n)입니다
def almost_linear(n):
    total = 0
    for i in range(n):        # n번 반복
        for j in range(3):    # 항상 3번만 반복 (n과 무관한 상수)
            total += j
    return total
반복 횟수가 입력 크기 n에 따라 늘어나는지, 아니면 고정된 상수인지를 꼭 구분해서 봐야 해요.
코딩테스트에 연결하기
백준 1330 두 수 비교하기처럼 입력이 두 숫자뿐인 문제는 아무리 복잡하게 짜도 O(1)이라 걱정할 게 없어요. 반면 백준 2751 수 정렬하기 2 는 데이터 개수가 최대 100만 개까지 주어지기 때문에, 정렬 알고리즘이 O(n log n)인지 O(n²)인지가 통과와 시간초과를 가르는 결정적인 기준이 됩니다. 문제를 읽을 때 "이 풀이는 몇 개의 반복문이 중첩되어 있고, 그게 빅오로 어떻게 표현될까"를 습관적으로 따져보는 것, 이게 코딩테스트 감각의 시작이에요.
한 줄로 정리하면
빅오는 상수와 자잘한 항은 무시하고, 입력이 커질 때 가장 크게 영향을 주는 항 하나로 알고리즘의 속도 등급을 매기는 표기법입니다.
직접 풀어보기 (연습문제)
- [난이도: 초급] 백준 1330 두 수 비교하기 — 입력 크기와 무관한 O(1) 코드를 직접 짜보며 "상수 시간"의 의미를 체감해보세요.
- [난이도: 중급] 백준 2751 수 정렬하기 2 — 파이썬 내장 정렬(O(n log n))과 직접 짠 이중 반복문 정렬(O(n²))의 속도 차이를 시간 측정으로 비교해보세요.
3. 로그(log)의 의미 — 반씩 줄여나가면 왜 빨라질까?
100만 개 중에서 숫자 하나 찾기
정렬된 데이터 100만 개 중에서 특정 값을 찾아야 하는 문제를 만났다고 해볼게요. 하나씩 다 확인하면 최악의 경우 100만 번을 봐야 하는데, "이분 탐색을 쓰면 O(log n)이라 20번이면 끝난다"는 이야기를 듣습니다. 100만이라는 어마어마한 숫자가 어떻게 20번으로 줄어드는 걸까요? 그 비밀이 바로 로그(log)에 숨어 있어요.
핵심 개념
로그(log n)란 어떤 수를 계속 절반으로 줄여나갈 때, 1이 될 때까지 몇 번 나눠야 하는지를 나타내는 값이에요.
비유로 이해하기
1000쪽짜리 두꺼운 사전에서 "algorithm"이라는 단어를 찾는다고 생각해볼게요. 첫 페이지부터 한 장씩 넘기면 최악의 경우 1000번을 넘겨야 하지만, 실제로 우리는 그렇게 찾지 않아요. 사전을 딱 가운데쯤 펼쳐서 "a로 시작하는 단어면 앞쪽, 아니면 뒤쪽"으로 절반을 통째로 버리고, 남은 절반에서 또 가운데를 펼치고… 이렇게 반씩 접어 나가죠. 스무고개 게임에서 "1부터 1000 사이의 숫자를 맞혀보세요"라고 하면, "500보다 큰가요 작은가요?"부터 시작해서 매번 반으로 좁혀가며 대략 10번 안에 답을 맞히는 것도 같은 원리예요. 이렇게 "매번 절반으로 줄이는" 전략이 왜 그렇게 빠른지, 그 횟수를 정확히 세어주는 도구가 바로 로그입니다.

수식으로 표현하기
n을 계속 2로 나누어 1이 될 때까지 몇 번 걸리는지가 바로 log₂n이에요. 100쪽짜리 사전을 예로 들면 다음과 같이 줄어듭니다.
100 → 50 → 25 → 13 → 7 → 4 → 2 → 1
한 번씩 반으로 줄일 때마다 1단계씩 세어보면 총 7번 만에 1쪽까지 줄어드는 걸 알 수 있어요(정확히는 log₂100 ≈ 6.64라서 7번째 만에 끝나는 것). 입력 크기별로 정리하면 이렇습니다.
n (입력 크기)log₂n (반씩 줄이는 횟수, 올림)
| 10 | 4 |
| 100 | 7 |
| 1,000 | 10 |
| 1,000,000 | 20 |
100만 개짜리 데이터도 겨우 20번이면 끝난다는 게, 바로 "반씩 줄여나가는 전략"이 그토록 빠른 이유예요.
Colab 코드로 확인하기
# 로그의 의미 — 시간복잡도: O(log n) (n을 반으로 줄이는 횟수를 세는 반복문)
import math

def count_halving_steps(n):
    """n을 1이 될 때까지 반씩 줄이는 데 몇 번이 걸리는지 직접 세어봅니다."""
    steps = 0
    while n > 1:
        n = (n + 1) // 2  # 올림 나눗셈: 홀수여도 절반씩 확실히 줄여나갑니다(사전이 홀수 쪽으로 남아도 안전하게 좁혀지도록)
        steps += 1
    return steps

# 입력 예시: 다양한 크기의 n에 대해 실제로 세어본 값과 log2(n) 이론값을 비교
for n in [10, 100, 1000, 1_000_000]:
    actual_steps = count_halving_steps(n)
    theoretical = math.log2(n)
    print(f"n={n:>9,d} | 실제로 세어본 반씩 줄이기 횟수: {actual_steps:2d}번 | log2(n) 이론값: {theoretical:.2f}")

# 출력 예시:
# n=       10 | 실제로 세어본 반씩 줄이기 횟수:  4번 | log2(n) 이론값: 3.32
# n=      100 | 실제로 세어본 반씩 줄이기 횟수:  7번 | log2(n) 이론값: 6.64
# n=    1,000 | 실제로 세어본 반씩 줄이기 횟수: 10번 | log2(n) 이론값: 9.97
# n=1,000,000 | 실제로 세어본 반씩 줄이기 횟수: 20번 | log2(n) 이론값: 19.93
코드 설명: count_halving_steps 함수는 이론 공식을 쓰지 않고 정말로 n을 2로 나누는 걸 반복하면서 몇 번 만에 1 이하가 되는지 직접 세는 코드예요. 이 값이 수학적으로 계산한 math.log2(n)을 올림한 값과 거의 일치한다는 걸 눈으로 확인할 수 있습니다.
틀리기 쉬운 포인트
⚠️ 로그의 밑(base)이 2인지 10인지 자연로그(e)인지에 따라 숫자가 달라진다고 헷갈려하는 경우가 있어요. 하지만 시간복잡도를 이야기할 때는 밑이 몇이든 상수 배 차이일 뿐이라 빅오 표기법에서는 그냥 O(log n)으로 뭉뚱그려 씁니다.
import math
math.log2(1024)   # 10.0  (밑이 2)
math.log10(1024)  # 3.0100...  (밑이 10)
# 값은 다르지만 "n이 커질 때 아주 느리게 늘어난다"는 성장 패턴 자체는 동일합니다
코딩테스트에서는 정확한 밑보다 "O(log n)은 O(n)보다 압도적으로 빠르게 끝난다"는 감각이 훨씬 중요해요.
코딩테스트에 연결하기
백준 1920 수 찾기는 최대 100만 개의 수 중에서 특정 값이 있는지 여러 번 확인해야 하는 문제예요. 하나씩 다 훑는 O(n) 방식으로 여러 번 검사하면 시간 제한을 넘기기 쉽지만, 먼저 정렬해두고 이분 탐색으로 찾으면 검사 한 번에 O(log n)만 들어서 여유 있게 통과할 수 있어요. 백준 10816 숫자 카드 2도 마찬가지로, 정렬 후 값이 몇 개 있는지를 이분 탐색으로 빠르게 세는 방식이 핵심이에요. 이 두 문제의 이분 탐색 구현 자체는 나중에 다른 글에서 자세히 다룰 텐데, 지금 단계에서는 "왜 그 방법이 그렇게까지 빠른가"를 로그의 의미로 미리 이해해두는 것만으로도 충분합니다.
한 줄로 정리하면
로그는 "반씩 줄여나갈 때 몇 번 만에 끝나는가"를 세는 값이고, 그래서 O(log n)은 입력이 아무리 커져도 놀랍도록 적은 횟수만에 끝납니다.
더 알아보기
n이 10배가 될 때 O(n)의 연산 횟수는 그대로 10배가 되지만, O(log n)의 연산 횟수는 겨우 몇 번만 더 늘어나요(예: log₂1,000 ≈ 10, log₂10,000 ≈ 13 — 10배가 됐는데 겨우 3번 늘었죠). 이렇게 입력이 아무리 커져도 거의 늘어나지 않는다는 점이, O(log n)이 "거의 O(1)에 가까운 초고속 등급"으로 불리는 이유예요.
직접 풀어보기 (연습문제)
- [난이도: 초급] 백준 1920 수 찾기 — 정렬 후 이분 탐색을 쓰면 왜 시간 제한 안에 들어오는지, log n 감각으로 먼저 어림잡아보세요.
- [난이도: 중급] 백준 10816 숫자 카드 2 — 정렬된 데이터에서 특정 값의 개수를 세는 데도 이분 탐색(log n)이 쓰인다는 걸 확인해보세요.
4. [코드+코딩테스트 연결] 같은 문제, 다른 복잡도
"N ≤ 100,000, 시간 제한 1초"의 무게
문제를 읽다 보면 맨 아래에 작은 글씨로 "1 ≤ N ≤ 100,000", "시간 제한: 1초" 같은 조건이 붙어 있어요. 별생각 없이 이중 반복문으로 풀이를 짜서 제출했는데 시간 초과가 떴던 경험, 다들 있으실 거예요. 사실 이 조건들만 잘 읽어도 "이 문제는 O(n²)으로 풀면 안 되겠다"는 걸 코드를 짜기 전에 미리 알 수 있습니다. 이번 에서는 같은 문제를 두 가지 다른 복잡도로 풀어보면서, 그 차이를 직접 시간으로 확인해볼게요.
핵심 개념
같은 결과를 내는 문제라도 반복문을 몇 겹으로 중첩하느냐에 따라 시간복잡도가 완전히 달라지고, 이 차이가 정해진 시간 제한 안에서 통과와 시간초과를 가르는 결정적인 요인이 됩니다.
비유로 이해하기
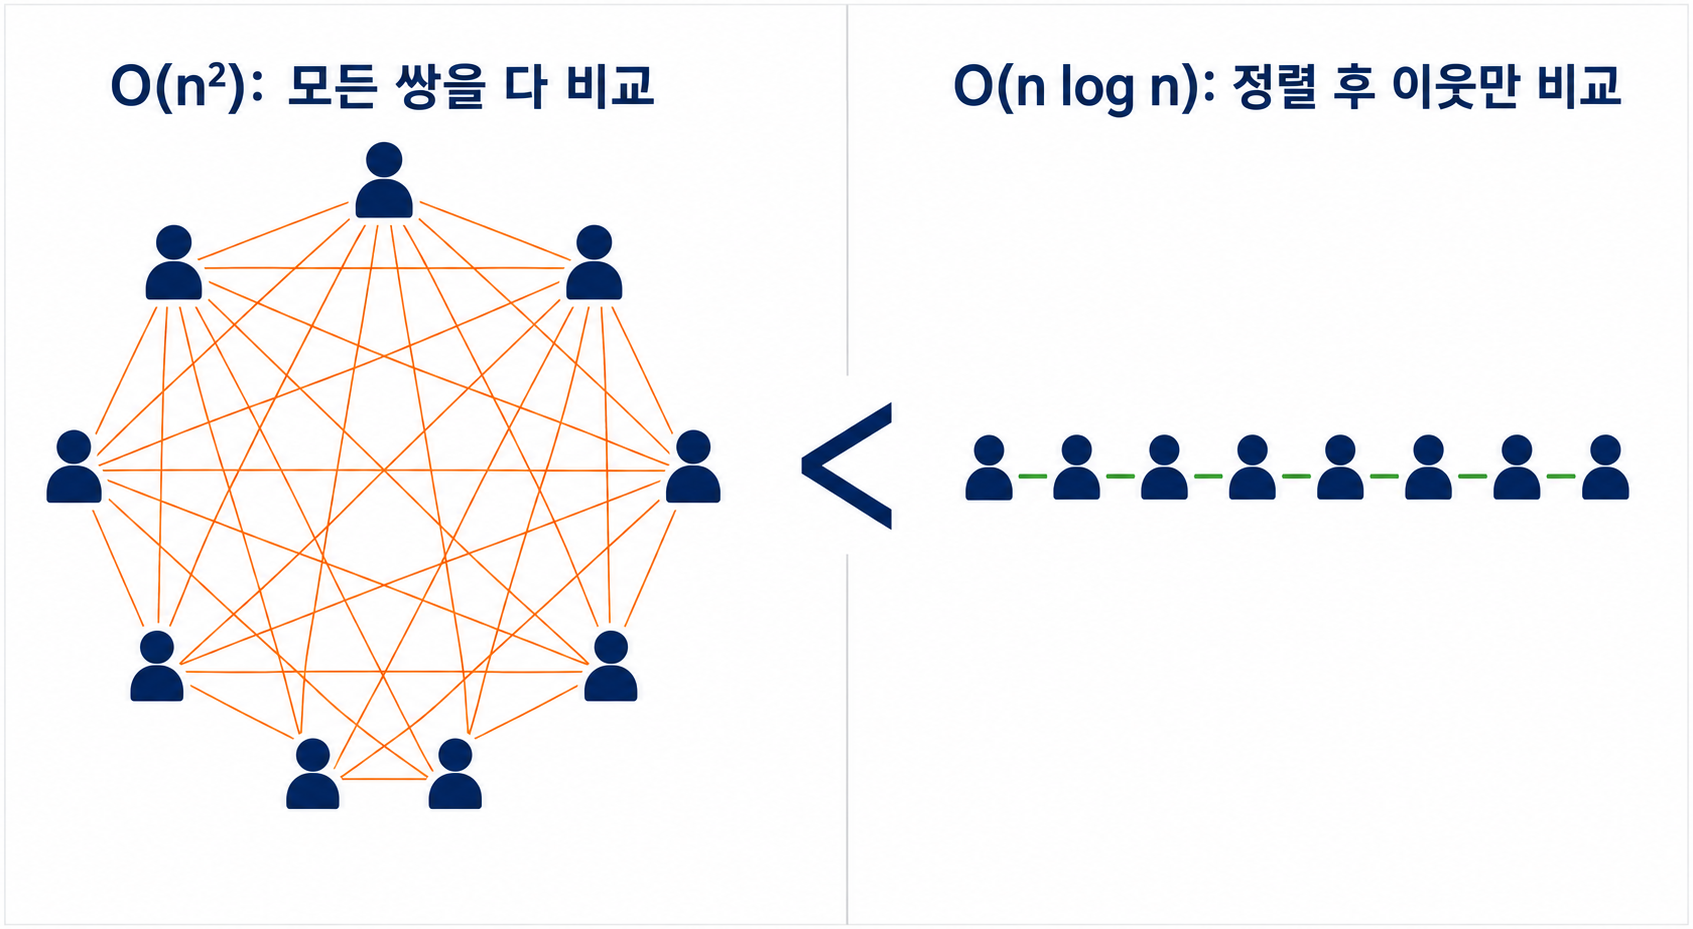
"우리 반 30명 중에 생일이 같은 두 사람이 있을까?"를 확인한다고 해볼게요. 첫 번째 방법은 모든 학생을 다른 모든 학생과 한 명씩 짝지어 생일을 비교하는 거예요 — 30명이면 약 435번의 비교가 필요하죠. 두 번째 방법은 전체 학생을 생일 순서로 한 줄로 세운 다음, 바로 옆 사람끼리만 비교하는 거예요 — 이러면 줄 세우는 데 시간이 좀 들어도 비교는 딱 29번이면 끝나요. 학생 수가 30명일 땐 큰 차이가 안 느껴지지만, 이게 10만 명이 되면 첫 번째 방법은 거의 50억 번을 비교해야 하고 두 번째 방법은 여전히 10만 번 안팎이면 충분해요. "모든 쌍을 다 비교하기"와 "정리해두고 이웃끼리만 비교하기"의 격차, 이게 바로 O(n²)과 O(n log n)의 차이입니다.
수식으로 표현하기
학생이 n명일 때, 모든 쌍을 비교하는 방법의 비교 횟수는 n(n-1)/2번으로, 이는 O(n²)이에요. 반면 정렬 후 이웃끼리만 비교하는 방법은 정렬에 O(n log n), 이웃 비교에 O(n)이 들어서 합쳐서 O(n log n)이 됩니다. 코딩테스트에서는 보통 "1초에 대략 1억(10⁸)번 정도의 기본 연산을 처리할 수 있다"는 경험적인 기준을 씁니다. 이 기준으로 N의 크기에 따라 어떤 복잡도까지 허용되는지 정리하면 아래와 같아요.
N (입력 크기)시간 제한 1초 기준, 대략 허용되는 복잡도
| N ≤ 11 | O(N!) |
| N ≤ 20 | O(2ᴺ) |
| N ≤ 500 | O(N³) |
| N ≤ 5,000 | O(N²) |
| N ≤ 1,000,000 | O(N log N) |
| N ≤ 10,000,000 이상 | O(N) 또는 O(log N) |
이 표에 따르면 N ≤ 100,000인 문제에서 O(n²)을 쓰면 연산 횟수가 약 100억(10¹⁰) 번이 되어 1초 안에 절대 끝나지 않아요. 반면 O(n log n)은 약 170만 번 정도라 여유 있게 통과합니다. 문제를 읽자마자 이 계산부터 해보는 습관이, "코드를 다 짜고 나서 시간초과를 받는" 시행착오를 크게 줄여줘요.
Colab 코드로 확인하기
# 같은 문제, 다른 복잡도 — 시간복잡도: has_duplicate_bruteforce는 O(n^2), has_duplicate_sorted는 O(n log n)
import time
import random

def has_duplicate_bruteforce(nums):
    """모든 쌍을 다 비교해서 중복 값이 있는지 확인합니다. O(n^2)"""
    n = len(nums)
    for i in range(n):
        for j in range(i + 1, n):
            if nums[i] == nums[j]:
                return True
    return False

def has_duplicate_sorted(nums):
    """정렬한 뒤 바로 옆(이웃)끼리만 비교합니다. 정렬 O(n log n) + 비교 O(n) = O(n log n)"""
    sorted_nums = sorted(nums)  # 파이썬 내장 정렬은 O(n log n)
    for i in range(len(sorted_nums) - 1):
        if sorted_nums[i] == sorted_nums[i + 1]:
            return True
    return False

# 입력 예시: 중복이 없는 무작위 수 6000개를 만들어 최악의 경우를 재현합니다
random.seed(42)
n = 6000
data = random.sample(range(0, 10_000_000), n)  # 서로 다른 값 n개 (최악의 경우: 끝까지 비교해야 함)

start = time.perf_counter()
result_brute = has_duplicate_bruteforce(data)
time_brute = time.perf_counter() - start

start = time.perf_counter()
result_sorted = has_duplicate_sorted(data)
time_sorted = time.perf_counter() - start

print(f"n={n:,}개 데이터 기준")
print(f"O(n^2)  브루트포스   : {time_brute:.4f}초, 결과={result_brute}")
print(f"O(n log n) 정렬 방식 : {time_sorted:.4f}초, 결과={result_sorted}")
print(f"→ 정렬 방식이 약 {time_brute / time_sorted:.0f}배 빠릅니다")

# n=100,000이면 O(n^2)은 실제로 몇십 초 이상 걸릴 수 있지만,
# O(n log n) 방식은 여전히 순식간에 끝납니다 (측정된 시간을 n^2 비율로 어림잡아 확인해보세요)
estimated_brute_100k = time_brute * (100_000 / n) ** 2
print(f"n=100,000일 때 브루트포스 예상 소요 시간(추정): 약 {estimated_brute_100k:.1f}초")

# 출력 예시(환경마다 수치는 다를 수 있음):
# n=6,000개 데이터 기준
# O(n^2)  브루트포스   : 1.5321초, 결과=False
# O(n log n) 정렬 방식 : 0.0021초, 결과=False
# → 정렬 방식이 약 730배 빠릅니다
# n=100,000일 때 브루트포스 예상 소요 시간(추정): 약 425.9초
코드 설명: 두 함수는 완전히 같은 질문("중복 값이 있는가?")에 답하지만, has_duplicate_bruteforce는 이중 반복문으로 모든 쌍을 다 비교하고 has_duplicate_sorted는 정렬 후 바로 옆끼리만 비교해요. 마지막 줄의 추정 계산은 O(n²)이 n에 대해 제곱으로 늘어난다는 성질을 이용해서, 실제로 100초 넘게 기다리지 않고도 n=100,000일 때 걸릴 시간을 어림잡아본 거예요. 정렬 알고리즘 자체의 원리는 나중에 다른 글에서 더 자세히 다룰게요.
틀리기 쉬운 포인트
⚠️ "일단 되기만 하면 된다"는 생각으로 테스트를 작은 입력에서만 돌려보고 통과라고 착각하는 경우가 많아요. n=100처럼 작은 값에서는 O(n²)도 순식간에 끝나기 때문에 문제를 못 느끼지만, 실제 채점은 문제에 주어진 최대 N(예: 100,000)으로 진행됩니다.
# 위험한 습관: 테스트 케이스가 작다고 안심하기
data = [1, 2, 3, 4, 5]  # 이 정도 크기면 O(n^2)도 눈 깜짝할 사이에 끝남
has_duplicate_bruteforce(data)  # 문제없어 보이지만...
# 실제 채점 데이터는 N=100,000일 수 있고, 그때는 완전히 다른 이야기가 됩니다
코드를 제출하기 전, 문제에 적힌 최댓값 N을 기준으로 시간을 어림잡아보는 습관을 들이세요.
코딩테스트에 연결하기
프로그래머스 "두 정수 사이의 합"(Lv.1)은 반복문으로 하나씩 더해도 O(n)이라 무난히 통과하지만, 등차수열 합 공식을 쓰면 O(1)로 즉시 끝낼 수도 있어요 — 같은 문제도 "왜 굳이 더 빠른 방법이 있는지"를 고민해보는 좋은 연습이 됩니다. 반면 백준 2606 바이러스처럼 그래프를 탐색해야 하는 문제는, 모든 정점 쌍을 억지로 비교하는 대신 연결된 것만 따라가는 O(V+E) 탐색을 써야 정해진 시간 안에 끝나요. 문제를 받으면 가장 먼저 "N의 최댓값이 얼마고, 그렇다면 내가 짜려는 반복문 개수가 감당이 되는가"를 따져보는 습관, 이게 이번 글 전체에서 가장 남겨가야 할 감각이에요.
한 줄로 정리하면
문제에 적힌 N의 최댓값과 시간 제한을 보면, 코드를 짜기 전에도 "이 반복문 개수로는 통과할 수 있는지"를 미리 가늠할 수 있습니다.
더 알아보기
"1초에 약 1억 번 연산"이라는 기준은 절대적인 법칙이 아니라 경험적인 어림값이에요. 파이썬은 C++이나 Java보다 같은 연산이라도 몇 배 더 느린 경우가 많아서, 실전에서는 좀 더 보수적으로 "1초에 약 2000만~5000만 번" 정도로 잡고 여유 있게 설계하는 것이 안전합니다. PyPy 채점 환경을 지원하는 경우 이 기준이 완화되기도 하니, 문제별 채점 환경도 함께 확인해보세요.
직접 풀어보기 (연습문제)
- [난이도: 초급] 프로그래머스 "두 정수 사이의 합" (Lv.1) — 반복문으로 O(n)에 푼 뒤, 수식으로 O(1)에 푸는 방법도 찾아 비교해보세요.
- [난이도: 중급] 백준 2606 바이러스 — 모든 컴퓨터 쌍을 비교하는 대신, 연결된 것만 따라가는 탐색이 왜 훨씬 빠른지 복잡도로 설명해보세요.
'AI를 위한 최소한의 수학' 카테고리의 다른 글
| 알고리즘 수학 3 - 경우의 수와 조합론 (0) | 2026.09.03 |
|---|---|
| 알고리즘 수학 2 - 정수론 기초 (0) | 2026.09.02 |
| 알고리즘 수학 시작 (1) | 2026.09.01 |
| AI를 위한 수학 15 - 딥러닝 전체를 수학으로 보기 (0) | 2026.08.13 |
| AI를 위한 수학 14 - 활성화 함수 (0) | 2026.08.13 |